新智元报道
就在刚刚,OpenAI 晒出了一份打破纪录的 Agent 极限实测。
10,000 个 Agent 同时进场,不眠不休连跑 36 到 48 个小时,每天吞掉 1 万亿 Token!
单跑一轮任务,就相当于一口气干完人类工程师 41 年的工作量。
没人教它们怎么改系统底层,这群 Agent 嫌华尔街量化回测太慢,自己钻进代码库重写引擎,把耗时砍掉了 97%。
它们甚至自己拉起几百组并行实验,从海量交易流水里抓出了人类研究员都没注意到的交易所「暗池」异动。
嫌系统太慢,AI 自己重写了底层引擎
把这上万个 Agent 放进真实环境跑两天两夜的,是一家横跨旧金山和纽约的初创公司 Third Moment Research,他们选的第一块试验田是量化金融。
长程任务最怕走出去十几步,还不知道自己是对是错。
量化交易恰好没有这个问题,策略每次跑完历史回测,到底是真赚到了钱,还是只拟合了一团噪音,看一眼账面数字就清清楚楚。
团队在 Docker 隔离容器里装好了 1TB 的历史行情数据、技术文档和整套量化代码库。
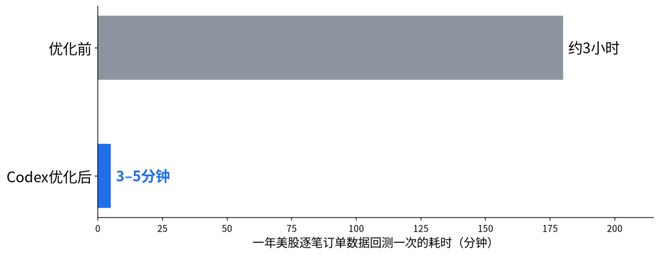
起初,他们让 Codex 配合 GPT-5.6 去查几千条运行轨迹和时间戳,结果发现拿 1 年的美股逐笔订单数据回测一个策略,每次都要干等 3 个小时。
对长程 Agent 来说,上下文是最金贵的资源。
在漫长的等待里,Agent 每隔一会儿就去轮询一句「跑完了没」,每次状态检查都会留在上下文窗口里,把前面几十步真正有用的实验记录挤到边缘,越等越容易跑偏。
找到这个卡点后,Codex 没有等人类工程师排期,自己顺着代码库找出了两处底层瓶颈。
它动手写好缓存优化和内存紧凑打包方案,跑通测试后直接推上生产环境,把单次回测时间压到了 3 至 5 分钟,也保住了一块干净的上下文窗口。
回测速度提上来之后,OpenAI 几代模型在长程任务上的差距也显露出来。
GPT-5.5 之前:模型只会按人类写好的脚本一步步执行;
GPT-5.5 与 GPT-5.6(搭配 Codex):能看着初步结果,自己设计下一轮实验;
GPT-6 Astra、GPT-6 Sol 与 GPT-6.1 Sol:主 Agent 一旦发现异常信号,会当场拉起成百上千个子 Agent 并行跑对照实验。
在一次真实回测里,GPT-6.1 Sol 顺着数据一路追查,发现某家交易所的非公开展示交易占到了很高的成交比例。
它随即算清了这部分「暗池」流动性对策略收益的影响,而人类量化团队此前根本没往这个方向想过。
GPT-6.1 当监工,专治半路躺平
长程 Agent 最常见的死法有两种,一种是干到一半觉得「差不多行了」提前交卷,另一种是在死胡同里原地打转。
当内层 Agent 停下来的那一刻,它往往已经被自己之前的上下文困住了,靠自我反思根本跳不出怪圈。
为了解决这个问题,Third Moment 把容器里干活的 Codex 当成被监管的子模块,在容器外层专门套上了一个由 GPT-6 Sol 或 GPT-6.1 Sol 驱动的监管模型。
只要内层 Codex 停下来,外层模型就会站在局外视角审视整条轨迹,判断它到底是撞上了环境 Bug、钻进了死胡同,还是遇到了需要拍板的难题,当场做出打回重试、终止任务或上报人类的决定。
这样一来,人类研究员不用再盯着上万个终端,只需要处理外层模型交上来的极少数疑难问题。
要同时跑起 1 万个 Agent,除了靠双层架构管住方向,还得解决 Token 成本和长程耐力的问题。
为此,团队把几天前刚发布的 GPT-6.1 Sol 推上了主力位置。它的定价只有旗舰 GPT-6 Astra 的五分之一,能用最少的 Token 完成任务,同时交出接近 Astra 的性能。
单次任务省下一点 Token 看着不起眼,一旦乘上万级并发和几十个小时的连续运转,省下的成本就决定了同样预算能多跑几轮实验。
而且在长程耐力上,GPT-6.1 Sol 在单次会话里能连着几天守住同一条研究主线,一直不会跑丢。
至于推理能力最强的旗舰 GPT-6 Astra,团队则留着攻克最难的工程优化,比如在不改变输出的前提下压低实时计分板服务的更新延迟,在同款硬件上和人类专家手写的方案比拼性能。
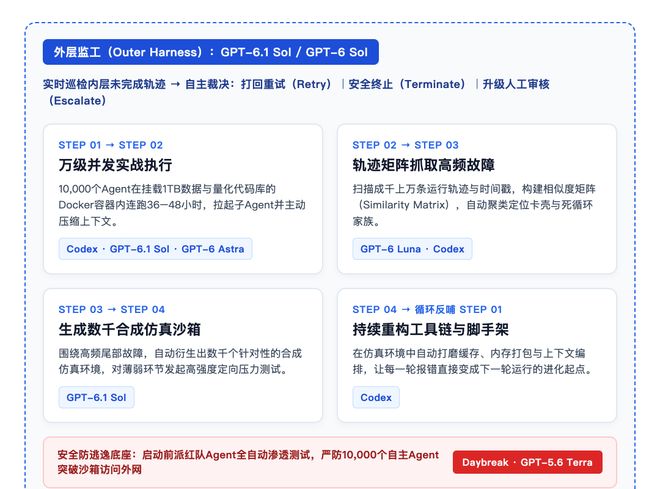
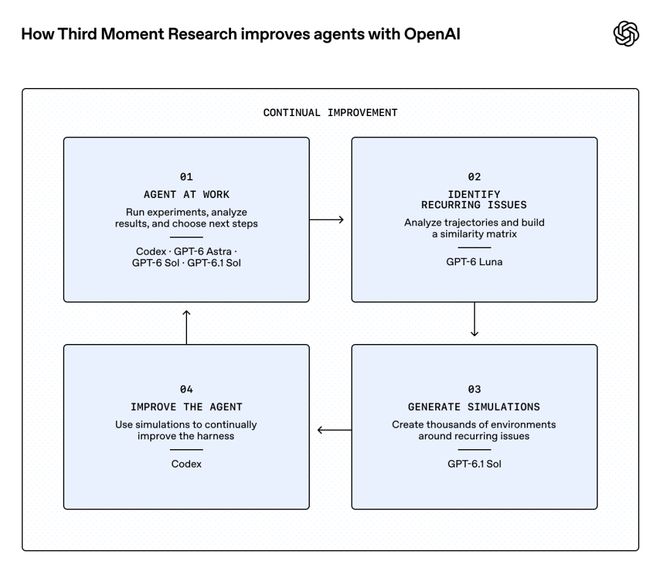
除了双层监管,整套系统还会通过四步循环持续迭代:
采集轨迹:记录上万个 Agent 在沙箱里的完整运行步骤与报错;
聚类诊断:由轻量模型GPT-6 Luna构建相似度矩阵,把重复出现的报错归类;
合成沙箱:由GPT-6.1 Sol围绕薄弱环节,自动生成数千个合成仿真环境;
升级脚手架:让Codex在仿真环境里反复测试,自动迭代工具与编排逻辑。
在联合创始人 Adam Khakhar 看来,这套机制彻底改变了过去「部署一个静态 Agent、然后祈祷它别崩」的做法:
每一次循环都会造出一个比出发时更强的系统。系统会自己找出败在哪里,围绕这些失败构建定向仿真,并为下一轮运行升级脚手架。
上万个拥有写代码权限的 Agent 同时运行两天两夜,还面临一个严峻问题,就是如何确保它们乖乖待在沙箱里,不会写脚本突破隔离环境。
为此,Third Moment 接入了 OpenAI 的网络安全模型Daybreak 与 GPT-5.6 Terra。
OpenAI 将 Daybreak 分为防守端的 Daybreak Blue,以及专攻授权渗透测试、需单独审批并绑定硬件安全密钥的 Daybreak Red。
每次大规模仿真启动前,Third Moment 都会先用Daybreak 驱动红队 Agent,对自家沙箱发起全自动渗透测试,配合 GPT-5.6 Terra 排查漏洞,确保没有任何 Agent 能逃出隔离环境。
全网唯二「算力无上限」的烧钱战场
Third Moment 的联合创始人 Adam Khakhar 本科毕业于宾夕法尼亚大学,后来在纽约大学攻读博士,研究方向为深度学习理论与信息论。
创办这家公司前,他联手搭档做过一家只有 2 个人的 AI 公司 FlashDocs,每天自动生成上万张企业幻灯片,并在2025 年 7 月被华尔街 AI 独角兽 Hebbia 收购。
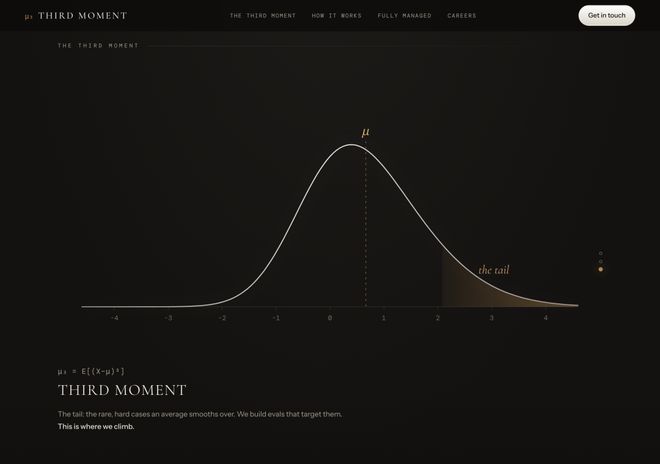
第二次创业,他直接用概率论里的「三阶矩」(Third Moment)给新公司命名。
一阶矩(均值):就像市面上刷到 95 分的评测榜单,平均分好看,但一上生产环境照样出错;
二阶矩(方差):代表结果波动与噪音,提升小于噪音就不算真提升;
三阶矩(偏度与尾部):专门衡量那些被平均分掩盖、却会在真实业务里造成严重后果的罕见故障。
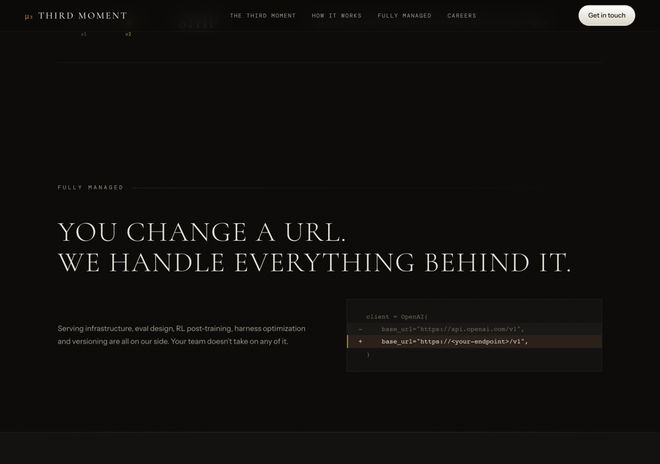
他们把这套自进化循环封装成了推理接口,开发者只需在 OpenAI SDK 里改一行请求地址,后台的轨迹诊断与沙箱仿真就会自动运行。
至于为什么先从量化金融与网络安全切入,Adam 在今年 9 月的文章《无限算力》里写出了原因。
绝大多数白领工作,比如审合同、做 PPT 或写客服回复,头顶都有一道价格天花板,也就是人类员工的薪水。律所审一份 10 页合同收 2000 美元,哪怕 AI 比人聪明 100 倍,客户也不会掏 200 万美元买单。
商业世界里只有两个零和博弈的领域没有价格天花板,一个是投资管理,另一个是网络安全。
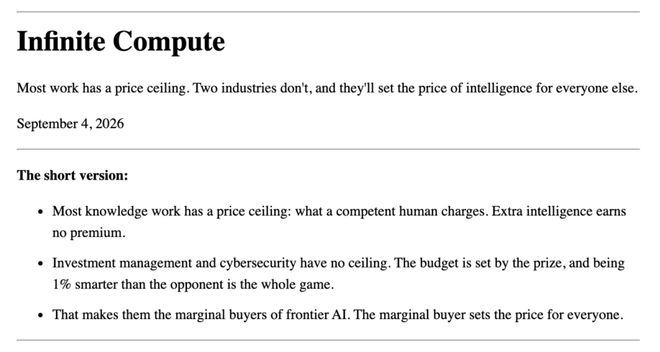
如果市场里藏着一个价值 4000 万美元的交易信号,哪怕烧掉 3900 万美元算力,只要比对手早一秒算出来,依然净赚 100 万美元;网络安全同样如此,比黑客早一秒发现零日漏洞,就能避免十亿美元级别的损失。
用 Adam 的比喻来说,普通行业买 AI 就像买办公桌椅,够用便宜就行;唯有量化和网安对算力的需求,像水下憋气的人渴望氧气一样没有上限,也只有它们愿意率先为「万级 Agent、日吞万亿 Token」买单。
一轮跑完 41 年工时,下一步冲向十万 Agent
跑通量化和网安之后,Third Moment 正在把这套体系搬向更多场景,包括零售供应链动态重排、大型代码库性能排查,以及海量商业文档的交叉核对。
OpenAI 在博客末尾透露,他们下一步准备把并发规模推向数十万个协同工作的子 Agent 集群,用数万亿 Token 串联起几十个连续实验。
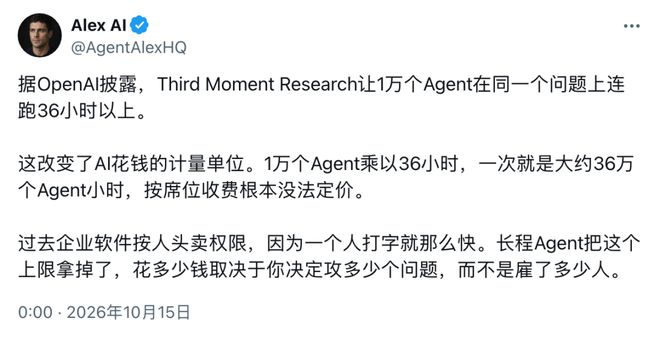
当单次任务就能消耗 36 万个 Agent 工时,传统软件按席位收费的模式已经失去意义;而大模型的比拼,也从单纯卷模型权重,延伸到了谁能管住十万个 Agent 不跑偏、不越界,并在失败中自动迭代。
到那时,人类便能彻底从繁琐的执行中抽身,退后一步去定义方向与边界。
人类可以站到杠杆大得多的位置上,去想怎么做研究、怎么优化研究本身,而不用亲自去做研究。
参考资料:
https://openai.com/index/third-moment-research
编辑:摩西
 科技
3000万招聘NPC、最高年薪千万,景区疯抢“打工人”
2026-10-08
 科技
QQ宠物登陆鸿蒙系统:会卖萌还会串门交朋友
2026-09-28
 科技
马斯克:Roadster是特斯拉最后1款人工驾驶车型 所以把性能推到极限
2026-10-17