新智元报道
训不起 2.8T 的 K3,玩够了 124M 的 nanoGPT,想试试十亿参数、万亿 token 的预训练,门槛有多高?
这类模型被广泛使用,例如经典的 Qwen 系列(Qwen2-1.5B,Qwen2.5-1.5B,Qwen3-1.7B……)。
不过 Qwen 系列尽管开源了权重,却未完整公开预训练配方。而 OLMo、SmolLM 等进一步开源了数据和训练细节,但复现依然昂贵:据估计,即使只有十亿级参数,复现 OLMoE-1B/7B 和 SmolLM3-3B 所需要的算力成本分别约为 20 万美元和 71.9 万美元。
对于普通实验室,知道「怎么训」还不够,还得真正「训得起」。我们需要一套低成本、可复现的「穷人版」预训练方案。
Puro-2B
全流程开源的「穷人版」预训练方案
围绕这个问题,清华大学陈文光教授与吕凯风教授团队联合推出全流程开源的Puro-2B(普罗-2B),开源了训练数据、训练框架、训练配置和模型权重。
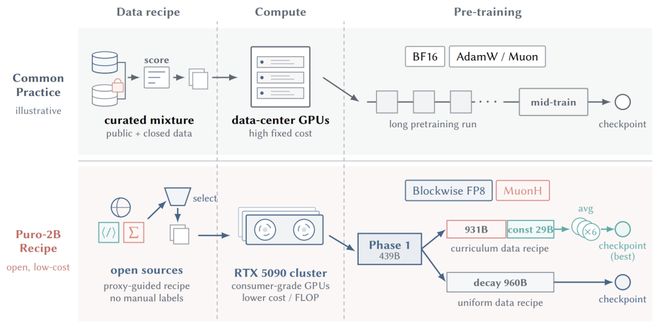
论文 Figure 3 | Puro-2B「穷人版」训练流程
他们在消费级显卡 RTX 5090 的计算集群上,从头训练了约 20 亿参数的模型,最多使用了 1.4 万亿 token。
在覆盖 15 项任务的综合性评测中,基于这套方案,以约 4400 美元的预训练计算成本,模型在 15 项任务平均指标上超过 Qwen2-1.5B。6900 美元成本的最佳版本,平均性能接近 Qwen2.5-1.5B。相比其他开源方案,Puro-2B 显著降低了训练成本。
论文链接:https://arxiv.org/pdf/2608.27370
开源材料合集:https://huggingface.co/collections/thu-pacman/puro-2b
模型与中间检查点:https://huggingface.co/collections/thu-pacman/puro-2b
训练数据与配比:https://huggingface.co/datasets/thu-pacman/Puro-2B
训练代码:https://github.com/thu-pacman/Puro-Megatron
数据处理代码:https://github.com/thu-pacman/Kaiyuan-Spark
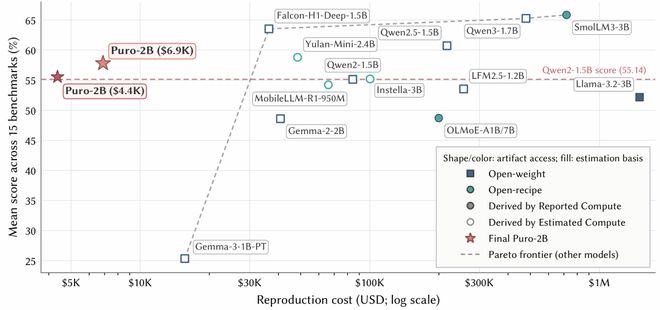
论文 Figure1|模型性能与复现成本
如果预算再少一些,能训练模型到什么水平?他们进一步拟合了成本—性能经验曲线(Puro Cost Scaling Law),用来估计不同预算下的模型能训出的水平。
他们从同一个第一阶段训练的检查点出发,调整第二阶段均匀数据配方的训练预算,来拟合平均性能得分与总成本的关系。
这条针对 Puro 训练方案的经验曲线,让研究者能够在正式训练之前,估计不同预算成本所能达到的能力水平,并结合需求调整训练方案,而不需要复现最长的模型训练过程。
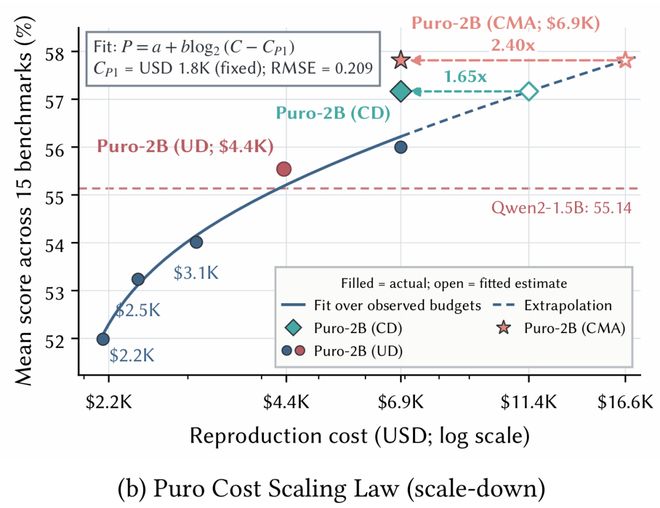
论文 Figure 2b|Puro Cost Scaling Law
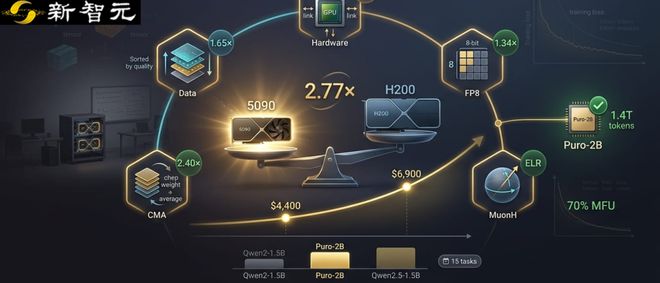
这套低成本方案,来自从硬件选择、低精度训练、优化器改进、高质量数据利用效率、数据选择这五个部分的协同设计。
单位成本,更高算力
相比于其他开源的训练方案,Puro-2B 团队从更基础、更底层、更贴近实际的问题出发:
同样的预算能买到多少算力?
按论文采用的 GPU 租赁价格计算,他们发现,RTX 5090 的 BF16 峰值算力/美元约为 H200 的2. 77 倍。这意味着单位成本,RTX5090 能比广泛使用的数据中心卡获得更多算力,同时 RTX5090 作为消费级显卡还兼顾了硬件的可获取性。
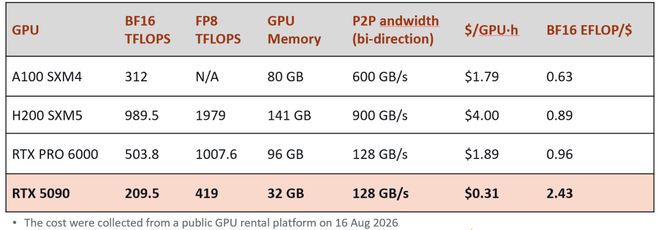
论文 Table2 简化|不同显卡的计算价格比值的统计与对比
但 RTX5090 只有 32GB 显存,也没有 NVLink,不能直接照搬数据中心 GPU 的训练配置。
Puro-2B 团队通过驱动和系统配置调整,在节点内启用 PCIe P2P 通信,将 GPU 间单向带宽从 31.5GB/s提升到56GB/s,通信延迟从 14.3µs降低到0. 4µs;
节点间启用 GPU Direct RDMA,让 24 卡 AllReduce 总线带宽从 8.87GB/s提升到19. 93GB/s。
Puro 的训练策略也针对十亿级参数规模的计算负载与 RTX5090 的硬件特点,进行优化:他们采用数据并行与流水线并行组合,避免通信频繁的张量并行;
通过重新分配流水线各阶段的计算量,调整微批次大小,并按显存占用情况均衡放置优化器状态,平衡不同节点的显存负载。
通过上述优化,综合 MFU 能超过 70%,消费卡的性价比通过这些工程适配与系统优化转化为训练成本的优势。
有了更划算的算力,下一步是提高计算精度效率。
FP8 发挥 RTX 5090 的低精度效率优势
RTX 5090 的 Blackwell 架构还为 FP8 训练提供了基础。他们沿用 DeepSeek-V3 的细粒度分块量化思路,将主要线性层的矩阵乘法放在 FP8 路径上,同时让数值敏感操作和训练状态保留 BF16 或 FP32 精度。
FP8 会带来一定精度损失。为判断是否划算,他们通过不同模型规模的对照实验(Scaling ladder),来验证了 FP8 训练带来的净效率收益。
通过五个模型规模的实验对照,他们发现,相比 BF16,FP8 的验证损失高出约0. 0031—0.0039,但差距较小且跨规模稳定。
与此同时,FP8 的训练吞吐效率得到1. 36 倍提升;把精度损失折算为达到相同损失所需的额外计算后,据估计仍有约1. 34 倍净效率收益。
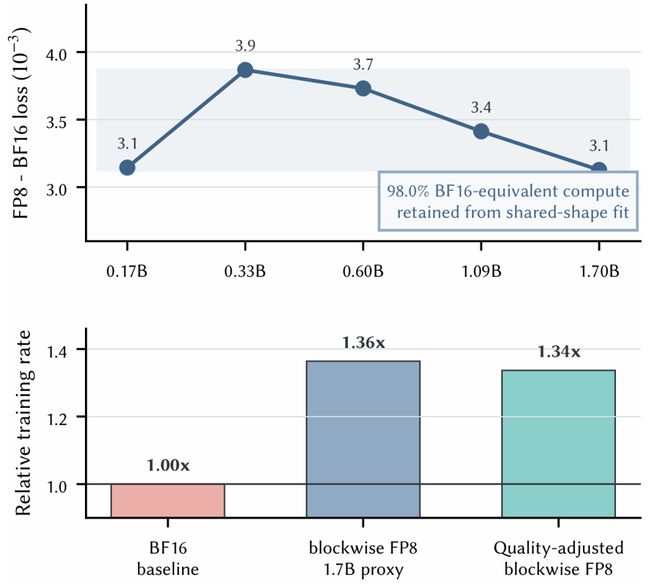
论文 Figure 10b|FP8 的损失差距与质量校正后的效率
从普通学习率到有效学习率
确定了计算精度后,如何设计优化器和学习率会影响每步更新的效果。优化器决定了每一步的更新方向,学习率决定了每一步的更新步长。
他们采用了新兴的 MuonH 优化器:在 Muon 基础上将权重的更新量做归一化处理,并在权重更新后,将权重投影回固定半径,从而同时控制更新范数和权重范数。
这样一来,衡量更新量相对权重尺度的有效学习率(Effective LR, ELR),就能被显式预设,而不随权重尺度在训练过程中的变化而间接漂移。
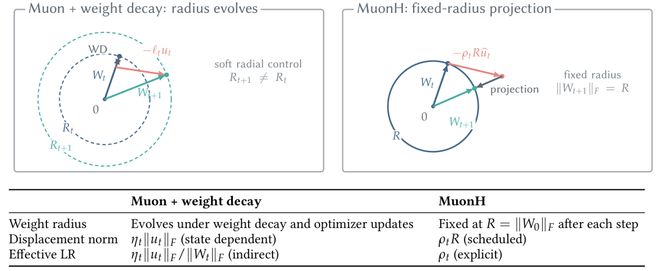
论文 Figure 4|MuonH 原理示意图以及与 Muon 的对照
他们的关键观察来自一组对照实验:用普通 Muon 不做固定半径的权重投影,只通过动态调整学习率,使训练过程的 ELR 轨迹与 MuonH 对齐,则损失曲线便几乎重合。
这说明,实际中 MuonH 的优势不能仅归因于范数约束,有效学习率 ELR 的变化过程才是理解超球优化有效性的重要线索。
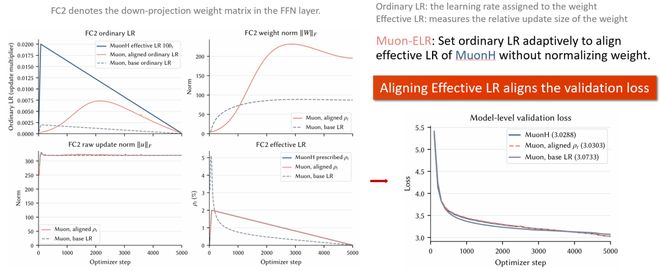
综合论文 Figure 5 与 Figure 15|ELR 对齐实验的解释与对照
进一步比较发现,在 weight decay 对权重范数约束不足时,普通 Muon 优化器的 ELR 在前期下降更快,损失也更早降低;MuonH 则保留更平缓的衰减,在后期表现更好。
这让他们把注意力从「用哪个优化器」,转向「如何设计更合理的有效学习率调度(ELR schedule)」。
随后,他们针对训练的衰减阶段占比对峰值学习率和训练数据量进行消融。结果显示,较高的峰值学习率和更长的训练周期,通常更需要较长的衰减过程。
因此,他们在训练第一阶段采用不依赖预设终点的power schedule,支持持续训练;第二阶段采用长线性衰减,为最终的损失收敛留出空间。
基于 Scaling Ladder 的比较进一步显示,MuonH 方案相比调参后的 Muon 基线,训练效率约为1. 19 倍。
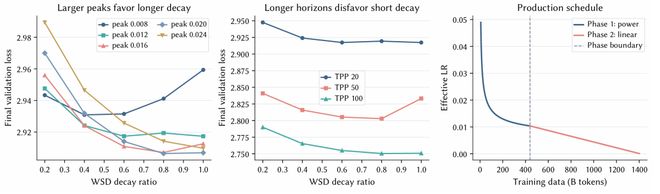
论文 Figure 6|学习率设计
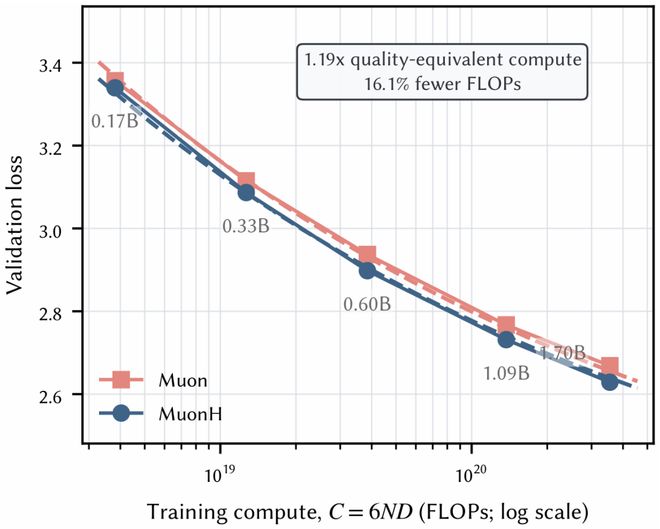
论文 Figure 10a|MuonH 的训练效率消融
把好数据放到训练后段
还要让模型学得进去
除优化器之外,数据效率还受数据排布影响。高质量数据在训练数据集中占比不高但是作用关键,放到训练后段有助于提高利用效率。许多开源数据集会同时提供样本的质量分数。
Puro 团队利用这些信号,在各数据源内部把更高质量的样本排到训练后段,再按训练进度对齐、混合不同来源的数据块。
这样既让训练过程中数据集逐步走向更高质量的区间,又保持局部训练区间的数据集配比近似稳定,避免质量变化同时造成领域数据比例的突变。
但数据排好了,并不等于模型能充分学到。Puro 团队此前的研究发现:当训练后期学习率过低时,最后出现的优质数据难以推动参数更新。为此,他们采用了课程模型平均(Curriculum Model Averaging,CMA)在训练后期保持恒定学习率,使模型继续学习优质数据,再对末端的检查点做权重平均,来缓解较高学习率带来的训练噪声。
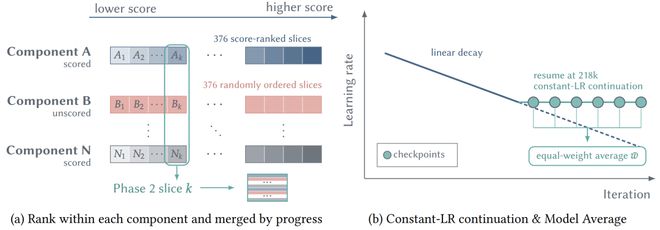
论文 Figure 7|课程数据构造与模型平均
进一步的消融也显示,直接在学习率衰减的训练轨迹上做模型平均,并不会稳定获益。真正需要配合的是数据顺序、后期学习率与模型平均策略。
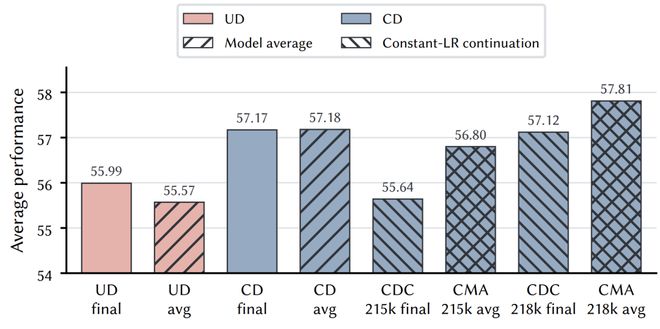
Figure 13b|对数据顺序、后期学习率与模型平均策略的消融实验
按 Puro Cost Scaling Law 这一经验曲线估算换算,相比于随机数据排布(Uniform, UD),数据课程加学习率衰减会相当于把成本效率提高到约 1.65 倍,完整 CMA 方案则达到约2. 40 倍。
数据评测
数据顺序解决后,还要决定选哪些数据。
他们建立了「数据源—数据切片—能力评测」的分层比较流程。对于大规模且有评分的数据集,分别抽取不同分数区间的数据切片;
其他符合条件的数据源采用随机切片。每个候选切片都从同一个检查点出发,在相同训练配置下继续训练,再用固定评测得到数学、代码、中文和通用能力的多维表现。
这既能比较不同数据源,也能发现同一数据源内部的质量差异。小规模替代实验(代理实验)还显示,相对于数学能力,代码能力对通用能力有更多削弱。
据此,他们在第二阶段适当提高了数学数据比重,同时结合领域覆盖和质量筛选确定最终配比。
这些小规模的实验为「选哪些数据、保留哪些分数区间、给不同来源分配多少比例」提供了一定参考,相关数据集评估结果也公开在报告中。
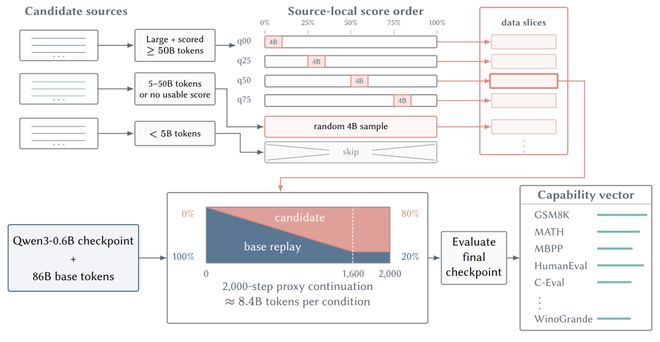
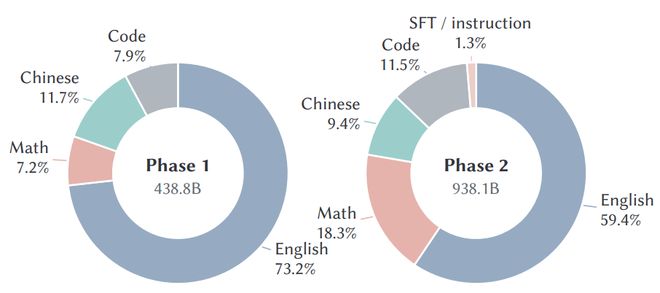
论文 Figure 9|代理评测流程;Figure 8|两阶段数据配比
从节省算力到覆盖训练流程
回看整套方案,各环节解决的是不同层次的效率问题:硬件降低每单位计算的价格,FP8 提高计算峰值以缩短执行时间,MuonH 提高损失值收敛速度,CMA 提高训练数据的利用效率,代理评测帮助选择更值得训练的数据。这些改进共同组成了 Puro 的低成本训练流程。
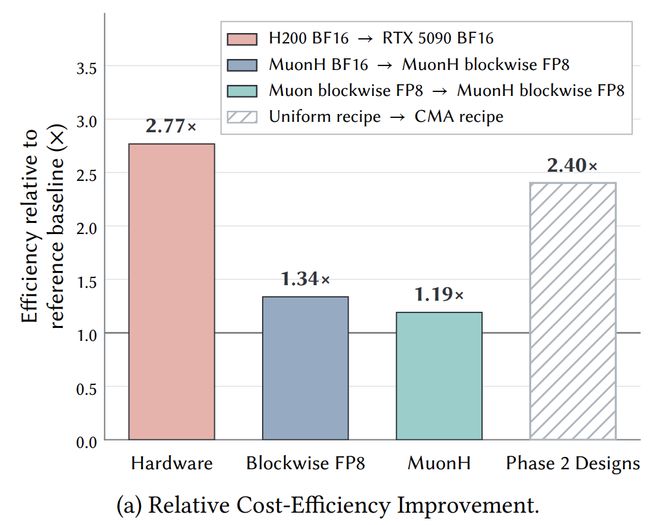
论文 Figure 2a|各环节效率收益汇总
那么,这套训练配方可以怎样用于研究或实践呢?例如,研究者可以控制预训练过程,再检验后训练结果。
一个例子是:研究者常关心,预训练阶段的方法改进,经过后训练之后还是否有效。如果只有开源权重,研究者很难控制模型此前的预训练过程;而 Puro-2B 让修改预训练的方法、继续做微调、检验最终效果成为一条可运行且成本可承担的实验流程。
Puro 团队对 CMA 与 Uniform 两个预训练权重采用相同的微调流程。在两组数学能力的微调实验中,基于 CMA 初始化微调的 GSM8K 准确率分别高出1. 77 和 2.02 个百分点;在 Tulu-3 混合领域微调中,15 项基准平均分提高1. 17 个百分点,IFEval 提高1. 36 个百分点。
三组对照均呈现总体提升,说明 CMA 的优势整体能够延续到后训练之后。由此而言,Puro-2B 提供的不仅是一个分数更高的模型,还是一套预训练的基础流程,用于检验预训练方法能否带来最终收益。
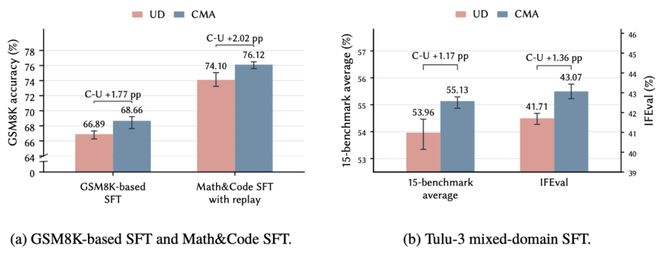
论文 Figure 11|CMA 与 Uniform 数据预训练的权重做微调后的对照
Puro-2B 普罗模型,名称就似乎和普罗大众有所关联,那么未来,究竟是模型厂商在 scaling 规模的路上一路狂飙,还是模型训练逐步成为普罗大众可及的一部分呢?普罗的尝试,也许正在使更多团队参与预训练研究成为可能。
参考资料:
https://arxiv.org/pdf/2608.27370
编辑:LRST
 科技
3000万招聘NPC、最高年薪千万,景区疯抢“打工人”
2026-10-08
 科技
QQ宠物登陆鸿蒙系统:会卖萌还会串门交朋友
2026-09-28
 科技
马斯克:Roadster是特斯拉最后1款人工驾驶车型 所以把性能推到极限
2026-10-17