文 | 字母 AI
微软让同一个大模型扮演五位“医生”组成会诊小组,其中一位 AI 医生专门负责抬杠。
在其他角色倾向于某个诊断时,它要找出其中的漏洞,免得大家沿着一条错误的思路越走越远。
这套名为 MAI-DxO 的系统,最近登上了《科学(Science)》杂志。
微软 10 月 22 日公布的结果显示,在用《新英格兰医学杂志》304 个疑难病例开展的测试中,它的诊断准确率约为 83%。作为对照,允许查阅资料的医生组,准确率约为 36%。
会诊小组里,还有一位专门管花费。如果便宜的检查能提供同样的信息,它就会建议替换,尽量省掉花钱多、作用小的项目。研究团队希望,这样的分工既能帮助 AI 找准病因,也能减少不必要的检查费用。
接下来,微软计划与美国一家医疗中心合作,让真实患者直接与系统互动。这场由 AI 自己给自己挑错的会诊,究竟怎么进行?
五个虚拟医生排排坐
给 AI 安排几个分工不同的角色,诊断过程会有什么变化?研究团队在论文中举了一个例子。
在这次根据历史病例进行的模拟诊断中,一位患者几个月来反复跌倒、腿部无力,还容易瘀青,伴有牙龈出血和牙齿脱落。
让普通 GPT-5“诊断”的时候,它把注意力放到了神经病变和自主神经问题上,接连安排了多项检查。
查到最后,它给出了一个涉及多种因素的解释,啥都说等于啥都没说,没能找准病因。
同样处理这份病例的 MAI-DxO,注意到了另一组值得联系起来的线索:患者做过胃旁路手术,平时很少吃水果,又出现了牙龈出血、掉牙的情况。系统由此考虑坏血病,并安排血浆维生素C检测,确认了这一诊断。
为什么 MAI-DxO 能做到?
核心秘诀就在于五位虚拟医生,它们由同一个底层模型扮演,各自承担诊断过程中的一项工作。
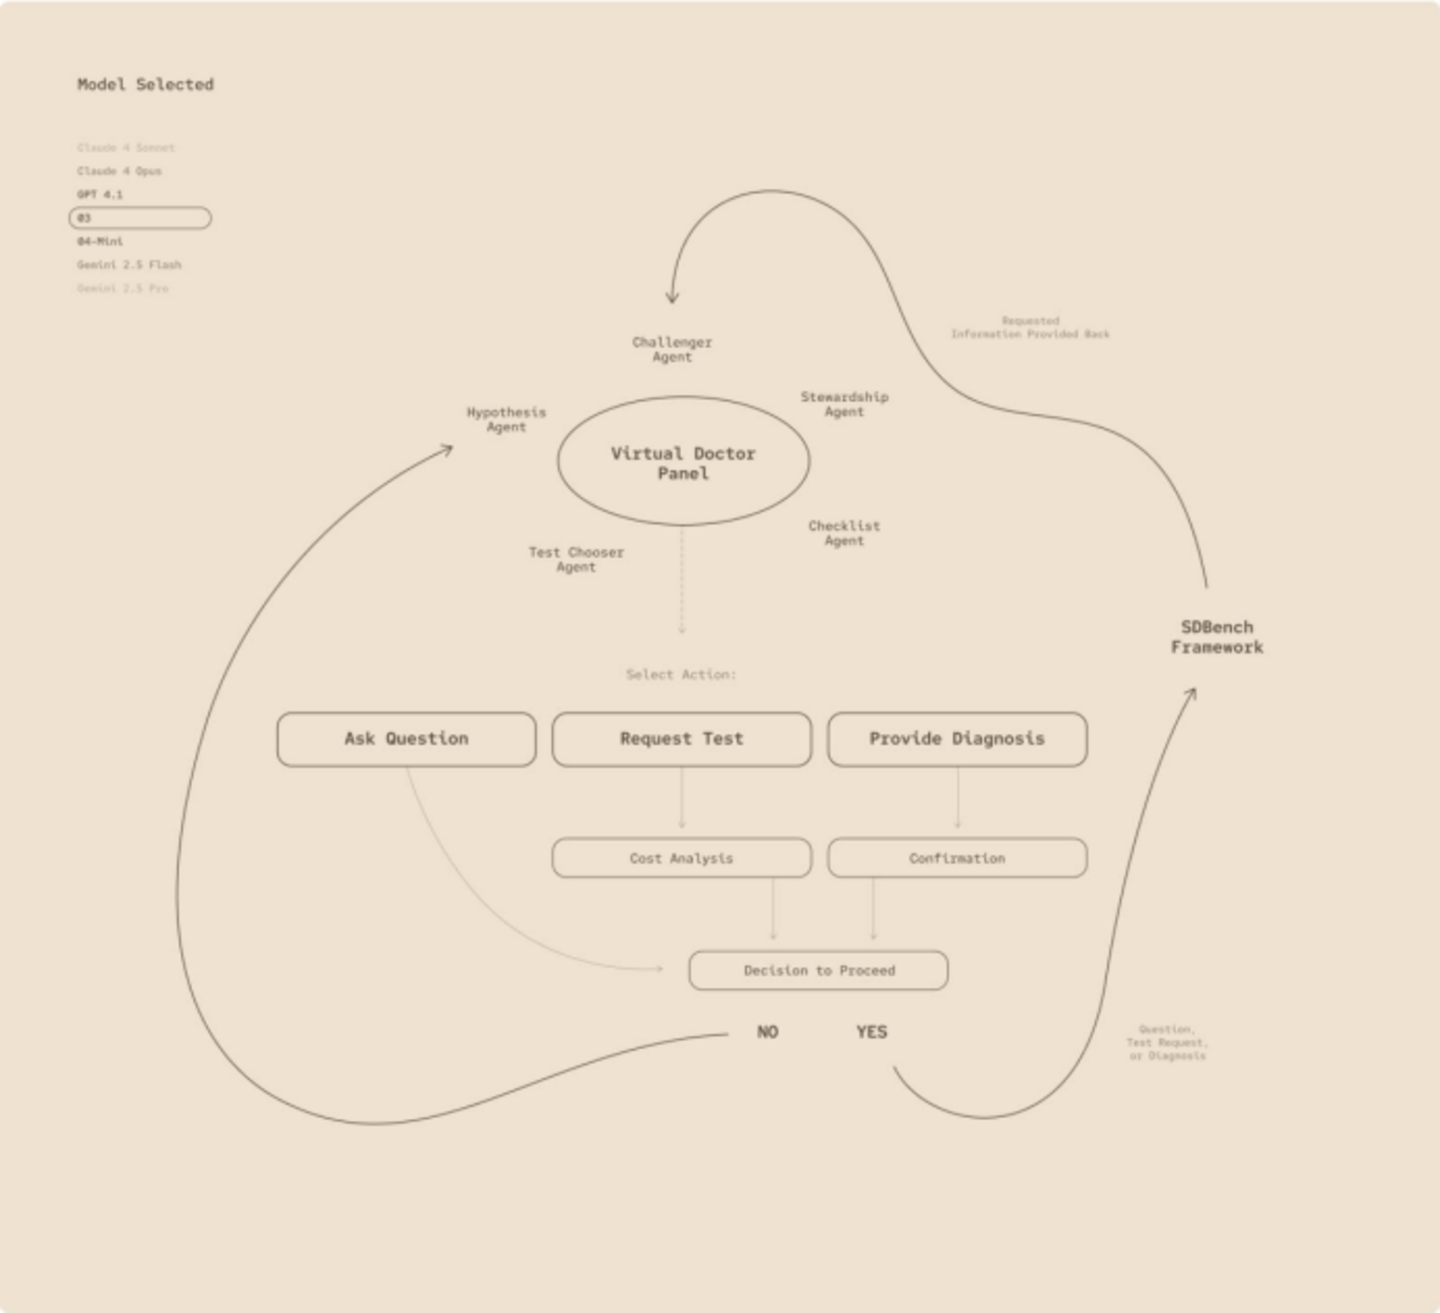
“诊医生(Dr. Hypothesis)”负责提出诊断,它会保留最可能的三种疾病,按可能性排序。有新证据出现,就重新调整。这样一来,暂时排在后面的可能性也还留在考虑范围内。
“查医生(Dr. Test-Chooser)”负责挑选做什么检查。它每轮最多选择三项检查。比如,假设两个诊断都能解释现有症状,一项检查无论结果如何,都不能帮助判断究竟是哪一种,它的价值就有限。
“杠医生(Dr. Challenger)”专门唱反调、抬杠,它要留意其他角色是不是太早认定了某种病,并把与当前判断矛盾的证据提出来。
拿前面的症状举个假设性的例子。如果一种诊断能解释腿部无力,却解释不了牙龈出血,讨论就不能停在“腿无力的原因找到了”。剩下的症状可能意味着,还需要考虑别的病因。这时候“杠医生”就得开麦了。
这个“杠医生”的角色很关键。研究人员复盘部分病例时发现,普通 GPT-5 或 o3 有时会被最初的判断带偏,没能及时调整诊断方向。“杠医生”的任务,就是提醒其他角色留意那些与当前判断不符的线索。
另外两位 AI 医生分别负责盯成本和做复核。
前者会比较不同检查的价值,诊断作用相当时,建议选择便宜的方案,如果某项检查价格高,又很难增加有用信息,它可以提出否决。后者在后台检查推理是否前后矛盾,以及开出的检查项目名称是否有效。
五位 AI 医生讨论之后,系统再决定下一步继续问病情、安排检查,还是给出诊断。检查结果出来后,这几位“医生”会再讨论一轮。如果结果不支持原先的判断,就要考虑其他可能的病因。
“AI 医生会诊”还真有用
为了检验这场会诊的效果,微软设计了一套叫 SDBench 的测试。
这个测试难就难在信息不完整。
以前有不少医疗 AI 测试会把症状、病史和检查结果一起交给模型,再让它给答案。SDBench 里被测者开局只能看到一小段病情介绍,想了解更多就得自己追问。如果觉得需要通过检查来获得更多信息,也得自己主动提出。
另一个负责提供信息的模型掌握完整病例,根据提问返回相应内容。比如,申请了某项血液检查,才能看到对应的结果。原始病历没有记载的部分结果,会由系统模拟补充。等参与者作出最终诊断,再核对答案,并估算此前安排的检查和就诊需要多少钱。
这来来回回之间,SDBench 测试就完成了。
首先是 AI 与人类的对决。
研究准备了两组病例。一组来自《新英格兰医学杂志》,包含 304 个疑难病例。MAI-DxO 的诊断准确率约为 83%。医生不能查资料时准确率仅约为 22%,允许查资料后约为 36%。
另一组是 325 个急诊患者的病例,系统准确率约为 80%,医生约为 47%。
两组成绩都拉开了差距,尤其是疑难病例。但这些病例本就以复杂、难诊断著称,参加测试的医生主要来自全科和综合内科,独立完成任务。我们至少可以说,从这个测试来看,AI 会诊团队要胜过单打独斗的人类医生。
其次是 AI 会诊团队与单个 AI 的对决。
作者公开稿列出的结果是,普通 GPT-5 在 NEJM 病例上的准确率为 78.9%,使用 MAI-DxO 后升至 83.2%,提高 4.3 个百分点。
费用变化更大。按研究的估算,普通 GPT-5 安排的诊断过程,平均每例需要 8409 美元;加入会诊流程后,降到 5430 美元,减少了近 3000 美元。不过,允许查资料的医生组平均费用为 4725 美元,仍然更低。
不过如果再给 AI 加上预算约束,MAI-DxO 又赢了。系统在开检查前估算费用,查看累计花费,并可以据此取消部分检查。在一个控制预算的配置中,MAI-DxO 的准确率为 80.9%,平均费用为 2241 美元,不到允许查资料的医生组一半。
下一站,急诊室
微软给这套系统安排的下一项任务,是到急诊室接受测试。公司已宣布与波士顿贝斯以色列女执事医疗中心(BIDMC)合作。
研究人员准备检验 MAI-DxO 能否帮助分诊,也就是判断哪些患者需要优先接受诊治。
毕竟在现实生活中,候诊患者的病情轻重缓急不同。AI 如果能通过追问发现提示病情严重的线索,就有机会帮助医护人员更早识别这些患者。
按照微软公布的计划,患者将直接与系统互动,研究人员再把 AI 的表现与医生独立作出的评估比较。目前,这项合作尚未公布临床研究结果。
把问诊 AI 带到真实患者面前这件事,谷歌也在推进,合作方恰好也是 BIDMC。
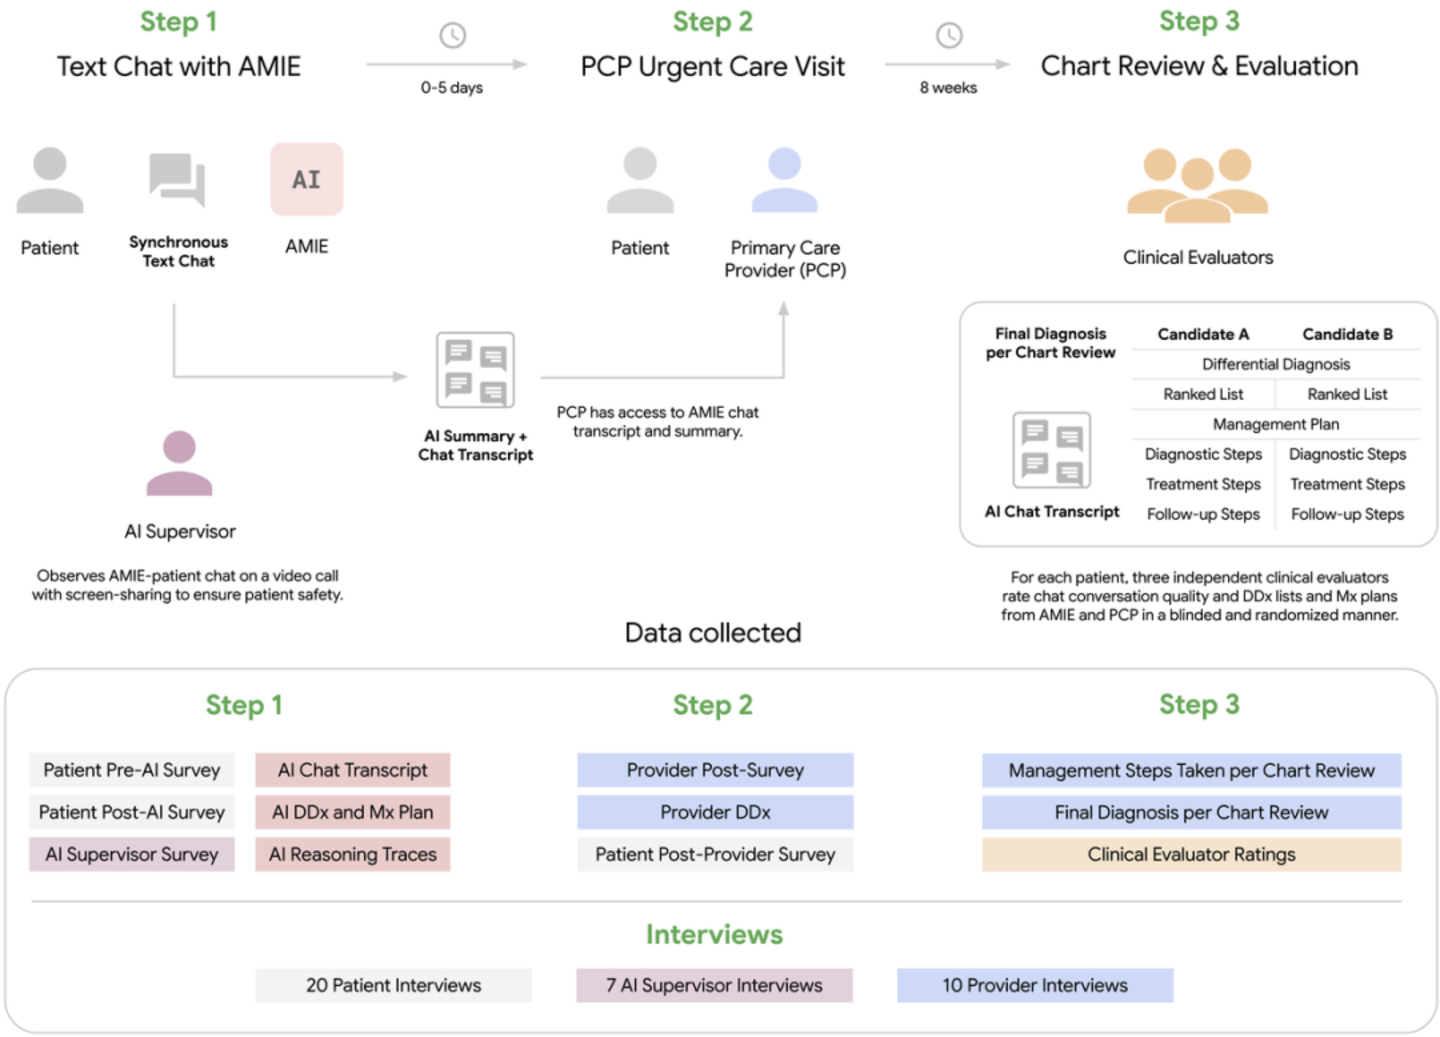
10 月 9 日,这家医院公布了与谷歌合作的 AMIE 研究。在这项可行性研究中,98 名患者完成了 AI 互动及后续门诊就诊。患者先在家里与 AI 进行文字对话,由它询问症状、收集病史,接诊医生可以提前查看对话记录或摘要。整个 AI 对话过程都有医生实时监督。
GPT-5 背后的 OpenAI,则在把产品接入医生使用的病历系统。今年 9 月,OpenAI 宣布,医疗机构可以将电子病历厂商 Epic 系统中的患者信息接入 ChatGPT for Healthcare。临床人员可以用 AI 梳理患者的检查结果、用药变化,并回查对应的病历记录。这类功能瞄准的是医生每天都要做的准备工作,让 AI 在接诊时派上用场。
从这些动作看,医疗 AI 的竞争已经延伸到了具体的诊疗环节。
同行在推进真实患者研究,也在争取让医生日常使用自己的产品。微软要把 MAI-DxO 继续往前推,同样需要把诊断能力的验证和产品开发联系起来。
微软手里已经有一批进入医院的工具。以医疗 AI 助手 Dragon Copilot 为例,它可以帮助医护人员整理诊疗记录,生成转诊信、就诊后摘要等文书。
微软今年 3 月披露,超过 10 万名临床人员在日常工作中使用 Dragon Copilot。这批用户,以及产品团队与医院合作的经验,构成了微软继续开发医疗 AI 的基础。
这也解释了微软为什么在发布研究成果的同时,宣布整合医疗相关团队,将微软研究院的科学家,以及 Dragon Copilot、PowerScribe 等产品团队汇集到 Microsoft AI。
从这次整合看,微软希望把诊断研究和医疗产品开发结合起来,让 AI 的判断能力用于医生的日常工作。
微软更大的野心是“医疗超级智能”。按照公司的设想,诊断只是其中一步,AI 还要帮助选择治疗方案,根据后续病情变化调整建议,并考虑患者的个人意愿和实际能获得的医疗服务。它希望未来的系统能够超越当今最强的临床团队和医疗系统。
很明显,这个目标还有很长一段路要走。但不得不说,科幻作品中果决准确但同时略显冰冷的赛博诊疗,似乎正在照进现实。
 科技
3000万招聘NPC、最高年薪千万,景区疯抢“打工人”
2026-10-08
 科技
QQ宠物登陆鸿蒙系统:会卖萌还会串门交朋友
2026-09-28
 科技
OpenAI前大牛认错!误判AI近十年,90%神经元只干一件事
2026-10-21