这两天,韩国 SK 海力士甩出了一份能把同行看哭的财报。
一个季度,营业利润约 620 亿美元,同比暴涨 632%,营业利润率 80%。相当于每卖一块钱的内存,就有八毛是纯赚的。
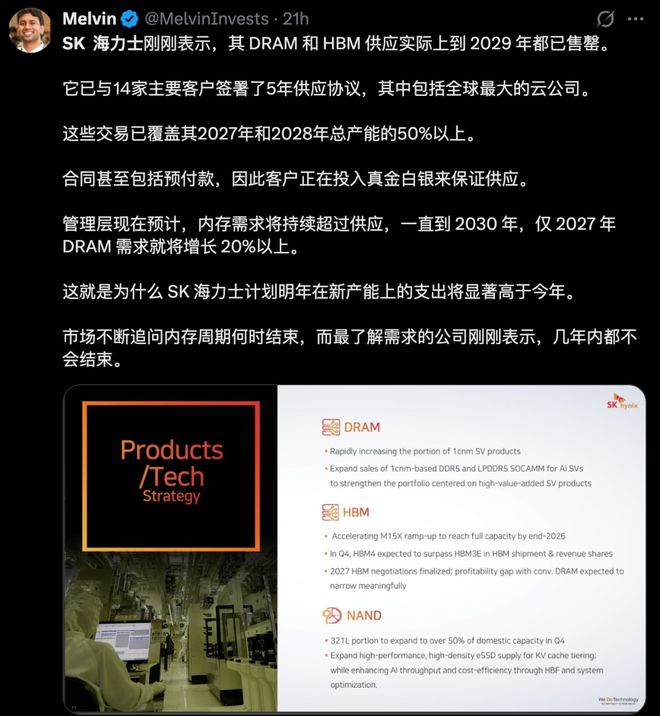
让人倒吸凉气的,是它顺手放出的预告——内存供不应求的局面,得一路延续到 2030 年;2027 和 2028 两年的产能,一大半已经被长约提前抢光了。
未来这波「内存吞金兽」,就是自动驾驶和机器人。
再往前倒一周,特斯拉三季度财报会上,马斯克也认了这个现实:AI5 芯片要到明年 4 月左右,才能真正装进擎天柱机器人。
为了把内存、封装、逻辑芯片这几道卡脖子的难关彻底打通,特斯拉还要自己建 Terafab 芯片厂。
光是到 2028 年初,就得先砸进去几百亿美元;往长远算,总投入甚至可能过千亿。
如今,模型参数规模越来越大,芯片和内存根本跟不上了。
那问题来了:没有特斯拉那么厚的家底,也不打算自己盖晶圆厂,这条路还能走得通吗?
今天,中国一家成立不到三年的芯片公司,交出了它的答案。
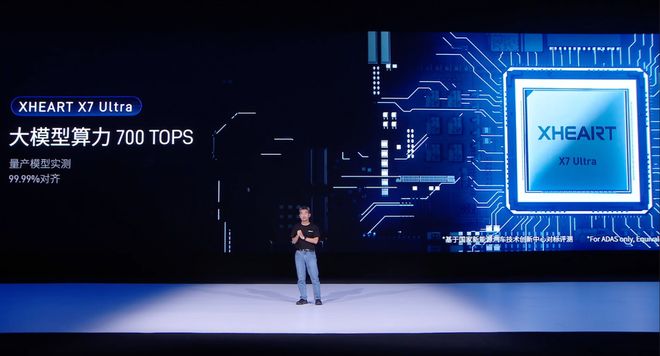
XHEART 新芯航途发布新一代大模型芯片 X7 Ultra,直接冲着十亿参数级智驾大模型去,算力 700 TOPS。
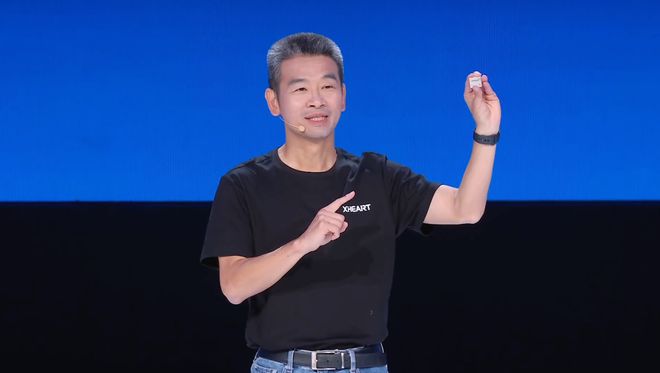
在模型表现相当的前提下,X7 Ultra 对标行业旗舰芯片,内存带宽消耗降了 80%
与此同时,兄弟公司 Momenta 同台分享 R7 Ultra 世界模型的最新进展。
而 XHEART 破局的解法,浓缩起来就一句话:让大模型来定义芯片。
模型换了脑子
芯片的考题也变了
过去的智驾,是一堆小模型拼起来的:感知、预测、规划各管一段,像流水线一样往下传。
信息每过一道手就被压扁一次,天花板也低,小模型能做多好,全看工程师想得多周全。XHEART CEO 李宗霖在台上说得直白,「那是人脑驱动的系统,工程师写规则,机器照着执行」。
但 Transformer 一出来,端到端大模型直接把这套老桌子掀了,智驾真正变成了吃数据的怪兽。
算法换了内核,跑算法的芯片,立刻就撞上了三堵新墙。
纸面算力,能不能在真实系统里发挥出来?
算力标多少 TOPS,就像是跑车的表底数字:标着能飙 300 码,早高峰堵在路上照样只能开 20。
对大模型来说,堵车的地方是数据搬运:参数和中间结果在内存和计算单元之间来回倒腾,计算单元算得飞快,然后干等数据。
更致命的是精度。关键计算为了提速砍掉精度,车上的决策就会「走样」。用户不在乎纸面数据,只关心车在路上反应快不快、判断及不及时。
今天的芯片,跟不跟得上明天的模型?
芯片从定义到上车动辄好几年,模型却半年一个大版本。设计时没预判模型往哪儿长、没留够资源,车卖出去没多久,OTA 升级就会撞墙。
能不能用合理的能耗,换来需要的能力?
提算力最直接的办法是堆晶体管,可车上的散热永远有一条硬边界,功耗暴涨的方案很难大规模上车。今年内存价格又翻了好几倍,数据在内存里多跑一趟,花的都是真金白银。
现实需要,这三道题得放在一起答。
特斯拉十年前跟 Mobileye 分手、自研芯片,看透的就是这一层。只是它的芯片从来只给自己用。
大模型定义芯片
到底定义了什么?
行业常规是先做芯片,再让模型去适配。
XHEART 的思路是反着来的——先搞清楚模型在车上到底是怎么跑的,再反过来设计芯片。
通用芯片像商场成衣,谁都能穿,谁穿都不太合身。XHEART 是量体裁衣,尺寸从大模型身上量,量尺握在兄弟公司 Momenta 手里:在上百万台量产车上跑着的真模型、真数据。
芯片的架构怎么搭、资源怎么分、怎么干活、往哪迭代,全围着大模型转。
落到 X7 Ultra 这颗芯片上,XHEART 有几刀切得非常准:
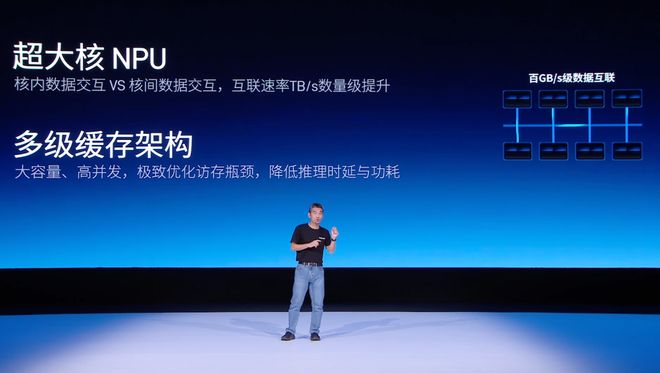
第一刀,直接上超大核 NPU。
传统做法是一堆小核分头干活,核与核之间传数据,速度在每秒百 GB 这个级别。
X7 Ultra 把它们聚成一个超大核,核内数据交互直接拉到每秒 TB 级,相当于把乡间小路换成了八车道。再配上大容量、高并发的多级缓存,数据尽量在芯片里面转,少往外面的内存跑,计算等待和能耗都跟着降下来。
第二刀,专用算子加速引擎。
早年的 NPU 为卷积网络设计,到了 Transformer 时代,一些计算只能甩给 CPU,来回切换还多读写内存。业界的办法是在 NPU 里加向量处理器。
这一次,X7 Ultra 给它们配了专门的硬件加速,原生支持 FP16 高精度计算,快和准两头都要。
第三刀,解锁 NPU 硬件并行。
计算单元同时开工,算东西和加载权重同步进行。好比生产线,原料提前送到工位,机器才能一直满负荷转。
第四刀,重构AI工具链。
常规推理每算完一步,就把中间结果写回外部内存,下一步再读回来。
X7 Ultra 的工具链把整张网络融合成一个「大算子」,中间结果不再进出外部内存,外部内存只管输入、输出和权重,整网内存零拷贝。
算力狂飙 700 TOPS,面向十亿参数级大模型
那这些改动换来了什么?
X7 Ultra 面向十亿参数级的智驾大模型设计,算力狂飙 700 TOPS。单看这个数,不算吓人。
狠的是它的考试规则:跑的是量产智驾大模型,芯片输出的可部署精度要达到「四个九」,也就是 99.99%。
在这套考纲下,成绩单非常亮眼:
用合作伙伴的 Transformer 量产智驾模型实测,计算利用率 98.7%。标称算力几乎一滴不剩全用上了。
在模型表现相当的条件下,对标行业旗舰芯片,内存带宽消耗下降 80%。
同样条件下,与行业旗舰产品相比,推理能效提升 100%。
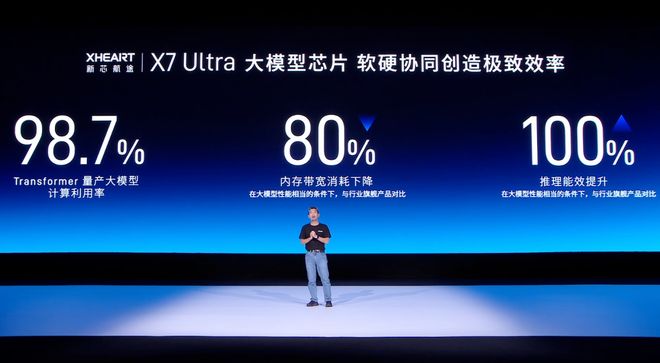
98. 7% 答的是第一道题,能效翻倍答的是第三道。至于 SK 海力士那个「缺到 2030」,别人还在排队交内存税,XHEART 先给自己打了个两折。
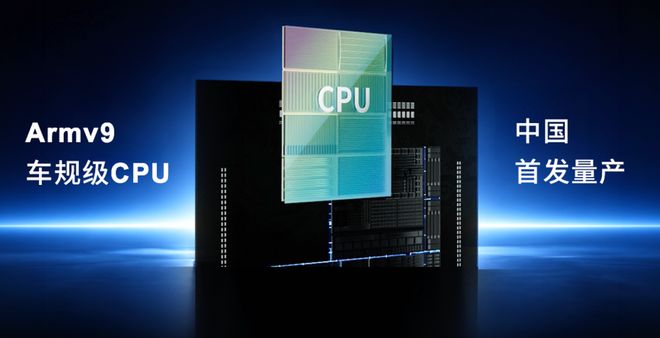
在配置上直接拉满,X7 Ultra 用上的 Armv9 车规级 CPU,XHEART 一举拿下中国首发量产资格。
激光雷达已经卷到上千线,X7 Ultra 专门配了加速器,每秒处理 2000 万个点。摄像头这边,X7 Ultra 专门加了本地计算的多核处理器,实测摄像头处理稳定性比竞品提升 100%。
另外,全新芯片功能安全满足 ASIL-B,内置 MCU 拿到最高等级的 ASIL-D,信息安全满足国密二级。
以上所有的设计,出发点都一样:先理解大模型,再设计芯片。
第一代 X7 已经证明,同样的芯片资源,能部署的模型参数量约是通用芯片的 10 倍。
一家三岁独角兽
凭什么让车企敢签单
技术讲得再漂亮,车企最后只问一句:敢不敢把车交给你?
车企选芯片,其实是在赌未来。一颗芯片从定点到上车要好几年,车上市后还要再卖好几年,可模型半年就迭代一轮。
光有前瞻思路还不够,在车圈,信任这东西只能靠真刀真枪攒出来。
先看带兵的人。CEO 李宗霖在芯片行业深耕了二十多年,在联发科做到无线通信事业部负责人,后来当过 OPPO 旗下哲库的 COO。
2023 年重新扎进创业浪潮时,他和曹旭东聊出两个判断:大模型会改变智驾,也会改变芯片的设计方式;汽车是大模型惠及普通人的起点,芯片得把性能、能效、成本一起做好。
核心团队一半来自头部芯片公司,一半来自一线智驾算法企业。
再看具体打法,主打的就是一个「快准狠」。
Momenta 把量产模型提前放进芯片的硅前验证,芯片还没造出来,模型已经在仿真里「试住」过了;制造交给台积电,整车表现跟车企一起磨。
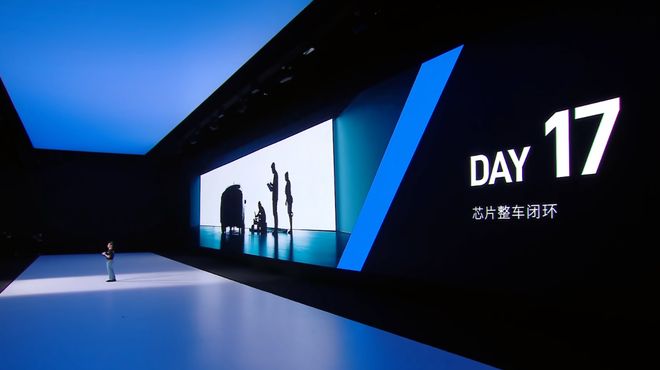
所以 X7 回片之后,速度快得离谱:不到 24 小时点亮全芯片,17 天完成整车闭环,21 天就接受合作伙伴的实车检验。客户坐进车里自己开一圈,比看一百页 PPT 都管用。
接下来,还要看省不省心。XHEART 不当 Tier1,但参考设计按主机厂量产标准验证,车企拿去就能开发。其中双 X7 方案用统一「双大脑」架构,一套硬件兼容 L3 和 L4,关键环节全冗余,已经拿到多个车型定点。
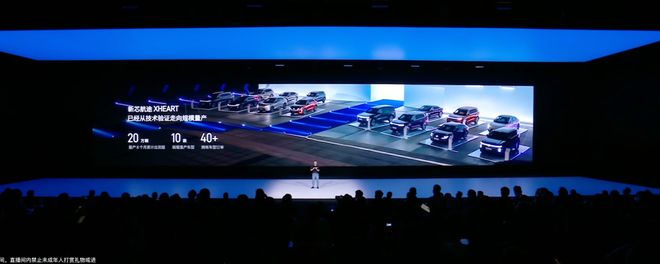
最后拿战绩说话。X7 系列量产 8 个月,累计出货 20 万颗,搭载 10 款量产车型,拿下超过 40 款车型订单。
首发车是上汽大众旗舰 SUV ID.ERA 9X,之后是荣威家越 07、MG 07,还有凯迪拉克、奇瑞的部分车型。从 30 万级的豪华旗舰到十几万的国民家用车,全线通吃。
值得一提的是,资本也在用双脚投票。就在前几天,这家独角兽刚敲定新一轮融资,累计将近 50 亿。
投资人名单里,有欧洲车企雷诺,还有国产内存龙头长鑫科技。一家内存厂主动入股一家大模型芯片公司,这步棋,值得细品。
世界模型 R7 Ultra 首发
未来芯片只会更牛
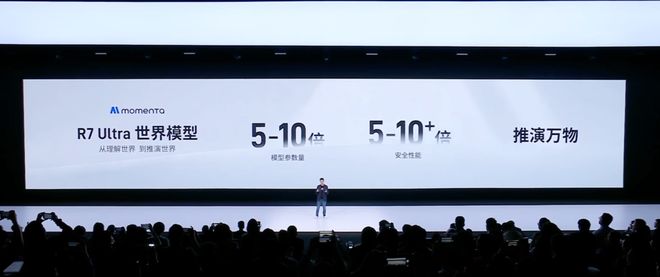
这一次大会上,「兄弟公司」Momenta 带来了下一代 R7 Ultra 世界模型。
参数量比上一代涨了 5 到 10 倍,安全性能提升 5 到 10 倍以上,「推演万物」的能力开始涌现。
X7 Ultra 托着 R7 Ultra,双方一起搭了个「世界模型基座平台」:Momenta 把模型往哪长提前告诉芯片,XHEART 按需求调架构;车端算力的实际条件,又反过来喂给模型研发。真实道路上跑出来的经验,再推着两边一起往前走。
Momenta CEO 曹旭东曾提出「智驾摩尔定律」——智驾的安全性和性能,每两年提升十倍。而大模型芯片,正在加速「智驾摩尔定律」,进一步提升至每年 10 倍。
这也让他做出了新的判断,2028 年前后,L4 便会迎来行业引爆点,20230 有望进入规模化落地。
这条定律想成立,模型得一直长,芯片也得一直跟得上。
这边,XHEART 按「量产一代、开发一代、预研一代」的节奏往前推,下一代 X9 已经在研发,瞄准的就是更高要求的 L4 自动驾驶和具身智能。
特斯拉证明了软硬一体是最硬的护城河,但它关起门自己用,还得自己盖厂扛账单。Momenta 和 XHEART 把模型、数据、芯片打通,再把这套软硬一体能力开放给全球车企。
马斯克为这件事准备了十年,还在砸钱。
XHEART 这边,用李宗霖的话说,从第一个提出「大模型定义芯片」,到「第一个」让大模型芯片大规模量产,不到三年。
三道题的答卷已经交了。接下来打分的,是每天开着这些车上下班的普通人。
编辑:桃子
 科技
3000万招聘NPC、最高年薪千万,景区疯抢“打工人”
2026-10-08
 科技
QQ宠物登陆鸿蒙系统:会卖萌还会串门交朋友
2026-09-28
 科技
OpenAI开始断网训练最强模型:“安全起见”
2026-10-27