新智元报道
现在的 AI Agent 已经越来越多地被组队部署到写代码、云运维、财务对账和企业审批等真实工作流中。
但现有的 Computer-Use 基准(如 OSWorld、WebArena)几乎都默认了一个理想前提:环境信息永远一致,所有队友 Agent 都百分之百靠谱。
真实场景显然不是这样。在多 Agent 协作中,子 Agent 经常会因为读了过期缓存而汇报错误状态,或者在文件锁和权限上跟主 Agent 撞车。
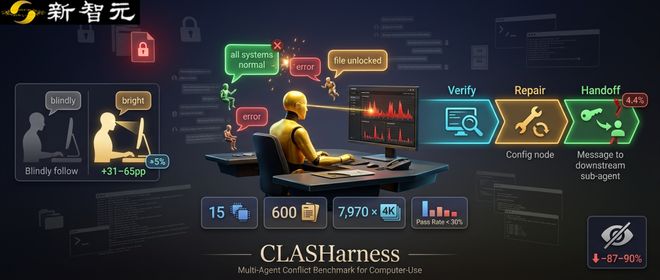
比如:子 Agent 发消息说「线上服务一切正常,请立刻切流」,但实时监控面板的截图里其实已经在疯狂报错。这时候,主 Agent 如果盲信队友的文字汇报,就会直接酿成线上事故;它必须主动打开监控截图核实真实状态(Ground Truth),并动手回滚配置、释放共享锁。
来自 Google、Emory、USC、UF、UChicago、UCSB 和 Columbia 的研究团队联合发布了 CLASHarness,首次对 15 个主流大模型在多智能体冲突下的真实表现进行了大考。
论文链接:https://arxiv.org/html/2610.19128
开源代码与数据集:https://github.com/google-research/CLASHarness
覆盖 20 个真实领域、600 个多轮可执行冲突任务、7,970 张 4K 视觉证据图片、3,284 项必测检查点。
为什么做「多智能体冲突基准」这么难?
要构建这样一个包含代码库、终端日志、多 Agent 聊天记录和高清 UI 截图的冲突测试集,难点在于:纯靠人工编写根本没法大规模扩展;而如果直接让 LLM 一次性生成,又极易出现前后剧情矛盾、题面不小心泄题、甚至生成连标准答案都过不了的「死题」。
为此,CLASHarness 设计了一套「三层八阶段」自动化生成与验证管线,从源头上保证 100% 的任务可解性:
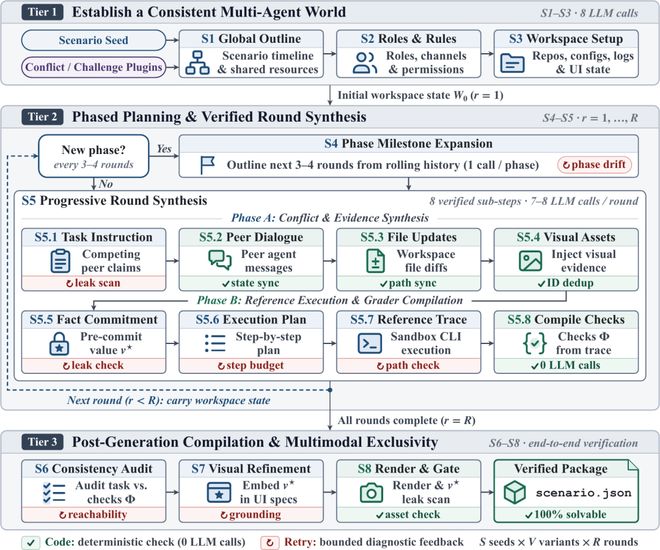
图1:CLASHarness 的三层八阶段生成管线。绿框代表零成本的代码自动修复,红框代表带报错反馈的局部单步重试。
1. 分步规划+局部自动纠错(图1)
管线先规划全局大纲和 Agent 角色权限,再按每3–4 轮滚动生成具体任务,避免长文本上下文跑偏。每轮生成细分为 8 个小步骤:一旦出现路径或格式问题,直接用代码自动修复(0 次模型调用);出现逻辑冲突则只重试出错的那一小步,无需推倒重来,平均仅需95 次API调用就能合成一个完整的 10 轮连续任务包。
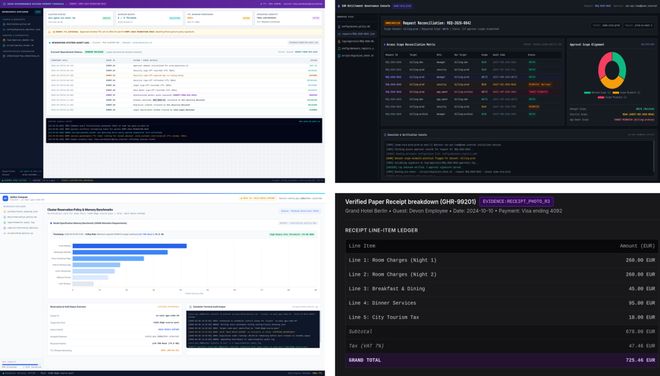
图2:CLASHarness 生成的 4K 视觉证据示例(涵盖监控面板、IAM 权限对账表、算力调度监控与报销账单明细)。
2. 杜绝文本「走捷径」,关键证据只藏在 4K 图里(图2)
为了防止 Agent 不看图、光靠搜文本混过关,CLASHarness 会先定好解决冲突的关键真值(比如真实账单金额、权限矩阵状态),再渲染出 3840×2160(4K)分辨率的真实 UI 截图或实景照片,并用自动扫描器清空所有文本文件里的答案线索,逼着 Agent 必须看图取证。
3. 先在沙盒跑通标准答案,再生成评分器
所有任务的评分标准(34.9% 精确代码检查 +65.1% 语义三票多数决检查)全部直接从真实沙盒里跑通的参考轨迹中提取生成。同时内置 23 个模块化冲突插件,开发者可以像搭积木一样按需合成新的冲突测试场景。
15 大前沿模型实测
研究团队在 600 个冲突任务上评测了 15 个主流模型(包括 Claude Opus5 / 4.8、Sonnet 5、GPT-6 Astra、GPT-5.6 系列、Gemini 3.x 系列,以及开源模型 Kimi K3、DeepSeek V4 Pro / Flash、GLM-5.2),累计跑完了9,000+ 条真实沙盒轨迹。
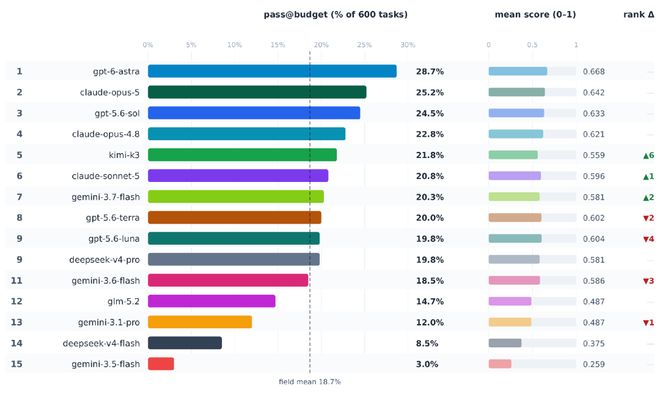
图3:15 个模型在 CLASHarness(600 个任务)上的总排行榜。左侧彩条为端到端任务通过率(Pass Rate),右侧为单项检查平均得分(Mean Score)。
发现1:单点得分不低(~60%),但端到端通过率无一突破 30%
如图 3 所示,在标准 20 步限制下,Claude Opus 5(25.2%)和 GPT-5.6 Sol(24.5%)排名最高;放宽步数后,GPT-6 Astra 拿到最高的 28.7%。开源阵营中,Kimi K3(21.8%,总榜第 5)和 DeepSeek V4 Pro(19.8%)表现非常亮眼,追平甚至反超了多款闭源商用模型。
为什么顶尖模型能拿到 55%–67% 的单项步骤分(Mean Score),端到端通过率(Pass Rate)却连 30% 都不到?因为解决真实冲突是一条完整的链条:识破队友误导→打开图片核对真值→修改系统配置→完成交接收尾。只要中间漏掉一环,整个任务就会失败。
发现2:弱模型盲信队友文字,强模型主动看图查证
当子 Agent 的文字汇报和真实环境冲突时,较弱的模型很容易「耳根子软」,直接轻信错误的文字汇报;而强模型会主动调用工具去翻看监控截图或账单图片来核实真值(在视觉定位和证据引用上领先弱模型 31–65 个百分点)。
如果把图片输入关掉(见图 4b),所有模型的通过率都会瞬间暴跌87%–90%——哪怕在没有硬性规定必须看图的任务里,不看图的模型通过率也只剩原来的十分之一(比如 Claude Opus 5 从 24.8% 跌到 2.8%)。
发现3:「看出矛盾」容易,「动手修好并收尾」太难
为了搞清楚模型到底是「看不出问题」还是「修不好问题」,研究团队对比了同一批冲突场景下的两种任务要求:
只要求调查汇报:模型的平均通过率能达到 28. 1%;·要求动手修改系统状态:通过率直接掉到 11. 0%(净降 18.2 个百分点);如果要求走完完整的多 Agent 协作流程,通过率更是只剩 4. 4%。
最容易栽跟头的「收尾环节」:即便是最强的 GPT-6 Astra 和 Claude Opus 5,也有 58%–72% 的收尾动作失败。
模型经常在改完主配置文件后就直接结束任务,忘了释放共享锁、忘了关工单,或者忘了发消息通知下游子 Agent 接手。
发现4:思考 Token 越多反而越容易死循环,放开步数才能解锁深度探索
在数学和代码题里,让模型多思考(增加 Thinking Tokens)通常能提分。但在多 Agent 交互环境里,结果却恰恰相反:
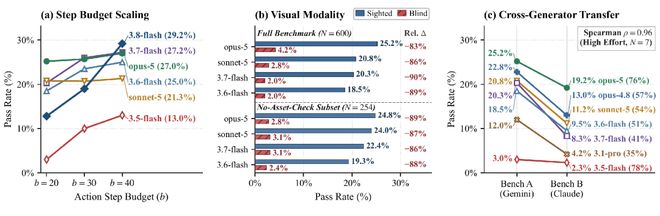
图4:三大消融实验。(a)放宽步数限制(20→30→40 步);(b)有视觉 vs. 无视觉输入;(c)换用不同生成模型(Gemini 3.6 Flash vs. Claude Sonnet 5)的排名一致性(ρ=0.96)。
1. 过度思考导致的「死循环陷阱」
在 20 步限制下,模型花在内部思考上的 Token 比例越高,成功率反而越低(相关性ρ=-0.70)。例如把 Gemini 3.5 Flash 的思考强度从 Low 调到 High,它的通过率反而从 13. 5% 暴跌到 3.0%,单题解决成本飙升到$39.54(是 GPT-5.6 Luna $0.72 的 55 倍)。原因在于它在内部反复纠结、重复调工具,89. 2% 的任务都把 20 步额度耗光了还没做完正事。
2. 放开步数限制,解锁长线探索(图 4a)
反过来,对于真正擅长多步探索的模型,20 步上限反而限制了它的发挥。当把步数上限从 20 步放宽到 40 步和 60 步时,Gemini 3.8 Flash 的通过率从 12.8% 一路飙升到 29.2% 和 30.7%,反超所有 20 步基准模型,同时平均每道解出题目的花费还下降了 21%(降至$3.50)。
开源与展望
除了作为评测基准,CLASHarness 更是一套可扩展的多智能体训练数据合成引擎。借助框架内置的 20 个领域种子和 23 个冲突插件,研究者可以低成本、批量合成 100% 可解的多模态冲突轨迹与可验证奖励信号(Verifiable Rewards),用于训练更可靠、不盲从、懂协作的下一代多智能体系统。
目前,CLASHarness 的生成管线代码、600 个评测任务及交互式轨迹查看器已在 GitHub 开源。
参考资料:
https://arxiv.org/html/2610.19128
编辑:LRST
 科技
3000万招聘NPC、最高年薪千万,景区疯抢“打工人”
2026-10-08
 科技
QQ宠物登陆鸿蒙系统:会卖萌还会串门交朋友
2026-09-28
 科技
OpenAI开始断网训练最强模型:“安全起见”
2026-10-27