新智元报道
在企业级真实业务与复杂数据分析中,让大模型「一眼看穿数据库并写出完美 SQL」,往往只是一个不切实际的幻想。
传统的 Text-to-SQL 大多将其简化为单轮文本生成:给定问题和静态 Schema,让模型一步生成最终 SQL。但现实数据库动辄包含上百张表、数千字段与百万级数据,资深分析师绝不会「单轮盲猜」,而是在 CLI 或 IDE 中执行 `SHOW TABLES`、探查表结构(DDL)、跑试探性查询(Probe Query),并根据报错反复修正逻辑后才提交代码。
在 Spider2.0、BIRD-Interact 和 LiveSQLBench 等长程交互基准上,传统静态微调模型纷纷暴露致命短板:训练时只学会「直接写终点答案」,部署到交互环境(Harness)后却缺乏探索试错、状态追踪与错误恢复能力,极易陷入死循环或因报错崩溃——即「训练与部署脱节」(Train–Deploy Mismatch)。
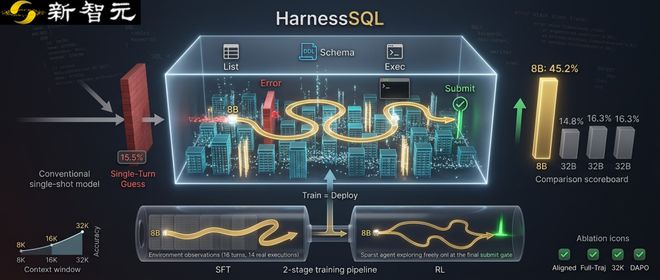
针对这一瓶颈,港科大与微软等团队推出了首个原生长程环境交互训练框架 HarnessSQL,在密闭沙盒与专用 SQL Harness 中进行长程轨迹监督微调(SFT)与执行奖励强化学习(RL)。
在 Spider 2.0-SQLite 上,HarnessSQL 仅凭 8B 参数即斩获 45.2% 执行准确率(近基线 3 倍),大幅超越 32B 专用模型(OmniSQL 14.8%、Arctic-Text2SQL 16.3%)与多智能体系统(MARS-SQL 12.6%),14B 模型更达 54.8%!
论文链接:https://arxiv.org/abs/2610.12274
开源代码:https://github.com/YangHaolin0526/HarnessSQL
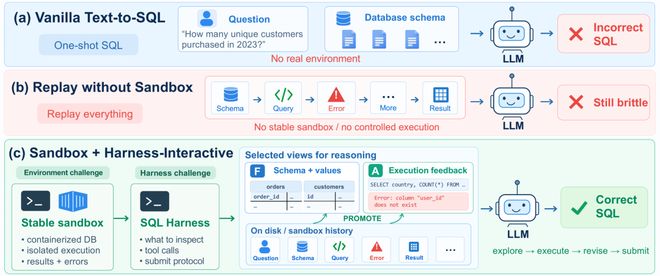
图1:从单轮 Text-to-SQL 到具备沙盒与专用 Harness 的交互式数据库 Agent 演进。
问题形式化与「训练-部署脱节」之谜
交互式 Text-to-SQL 可形式化为由执行环境契约(Execution Harness)调解的部分可观测马尔可夫决策过程(POMDP)。任务实例定义为四元组 x = (q, D, h, v),分别对应自然语言指令q、底层数据库D、执行 Harness h 与隐藏真实验证器(ExecutionOracle)v。
在第 t ∈ [1, T]轮交互中,智能体根据环境观测o_t∈O,由策略π_θ生成推理与工具调用行动a_t∈A,完整轨迹表述为:
其中y为终止步提交的最终 SQL,任务成败由联合奖励函数评估:
其中,
R_result (y, v)∈{0, 1}:在真实数据库D上比对候选产物y与标准答案v的执行结果集外延等价性,打破表层字符匹配局限;
R_protocol (τ, h)∈{0, 1}:校验轨迹是否遵守 Harness 契约(只读权限、语法合规、无死循环且在T步内显式提交)。
然而,现有后训练框架大多仍停留在传统的静态监督损失:
这种静态训练模式导致了三重核心脱节:
1. 抹杀中间探索状态:只将最终 SQL 作为目标,忽略了中间探测表结构与验证假设的交互过程;
2. 面对执行反馈盲目:训练时从未见过运行报错或空结果集,推理时一旦遇到报错极易崩溃;
3. 缺乏动作边界约束:模型不理解数据库 CLI 的权限边界与终止协议,易产生工具格式幻觉。
让智能体在真正的执行沙盒中淬炼
为打破上述脱节,HarnessSQL 构建了三大基石:高保真密闭执行沙盒、极简 SQL Harness 契约,以及两阶段长程后训练流水线。
1. 密闭 SQL 执行沙盒与蓝图合成
团队基于 Spider 2.0-Lite(30 个 SQLite)与 Spider 2.0-DBT(49 个 DuckDB,零损迁移至 SQLite)构建了 79 个复杂数据库沙盒,并采用SQL-First 蓝图合成法:先从活动引擎提取 Schema、样本值与外键路径,采样出难度可控的可执行 SQL,再反向生成自然语言问题与验证 Oracle。
沙盒具备只读绑定、单语句约束与 60 秒超时保护,并通过语法、非空与语义变异测试(Mutation Tests)保障数据质量。
2. 专为 SQL 任务定制的极简 Harness 契约(DSH-SQL)
通用编程 Agent 的繁杂 Bash 工具易导致模型注意力涣散。HarnessSQL 改造了 DeepSeek-Harness(DSH),提炼出四元极简动作契约:
sql_list_tables:枚举数据库内所有数据表及各自的数据行数;
sql_schema:探查指定表的完整 DDL 定义、字段类型与真实采样数据;
sql_exec:试探性执行只读 SQL 查询,获取前排真实输出或运行时错误堆栈;
sql_submit:终极提交已验证正确的 SQL 产物并退出长程会话。
环境中间件同时内置三大护栏:确定性行数截断防止大输出撑爆上下文;循环调用警示器主动纠偏重复无效查询;压力触发上下文压缩确保长程探索保留核心事实。
3. 原生 Harness 两阶段后训练:SFT 筑基 +RL 登顶
第一阶段:全轨迹长程 SFT(冷启动)。利用教师模型在沙盒中自主探索,筛选通过 Oracle 验证的优质多轮轨迹(平均 11.8Ktokens、16 轮交互、14 次真实执行)进行全序列监督:
关键机制:计算损失时,所有环境观测 token(o_t)均被掩码忽略(Masked Out),仅在模型自身生成的推理、工具调用与最终提交上计算梯度,迫使模型学会根据环境反馈推演下一步行动。
第二阶段:执行奖励强化学习(自主进化)。为赋予模型应对未知数据库的试错能力,HarnessSQL 采用动态解耦裁剪策略优化(DAPO)在沙盒中持续对齐,计算轨迹组标准化优势:
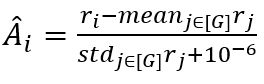
奖励信号完全依托隐藏 Oracle 的真实执行对比:结果等价且合规得 1 分,报错、超时或结果不符均得 0 分。不设任何人工中间奖励(Reward Shaping),倒逼模型探索出稳健的自纠错策略。
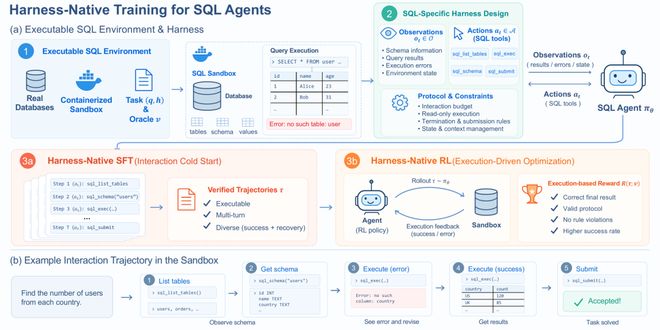
图2:HarnessSQL 整体架构流水线与沙盒交互轨迹示例。
实验评测
团队在三大真实数据库基准上展开评测:域内长程交互基准Spider 2.0-SQLite、含用户模拟器的域外动态交互基准BIRD-Interact Mini,以及跨领域复杂推理基准LiveSQLBench Base-Lite SQLite。
对比基线涵盖通识编程模型(Qwen2.5-Coder-32B)、前沿 SQL 专用模型(OmniSQL 7B/32B、Arctic-Text2SQL 7B/32B)与多智能体系统(MARS-SQL 3×7B),统一采用执行准确率(Execution Accuracy)评估。
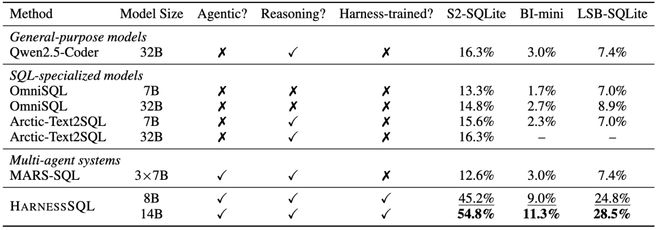
表1:三大基准上的执行准确率对比,粗体为最优,下划线为次优。
实验呈现出三大核心结果:
1. 8B 小模型全面反超 32B 模型:在 Spider 2.0-SQLite 上,HarnessSQL-8B 达到45. 2%,较同底座基线(15.5%)提升近 3 倍,大幅超越 OmniSQL-32B(14.8%)、Arctic-Text2SQL-32B(16.3%)和 Qwen2.5-Coder-32B(16.3%)。
2. 14B 模型逼近 55% 大关:扩展至 Qwen3-14B 后,执行准确率进一步攀升至54. 8%,验证了原生 Harness 训练出色的规模扩展性。
3. 强劲的域外泛化能力:在未见过的 BIRD-Interact Mini 与 LiveSQLBench 上,HarnessSQL 同样遥遥领先。其中在 LiveSQLBench 上,8B(24.8%)与 14B(28.5%)达到所有 32B 基线(7.0%–8.9%)的3~4 倍,证明模型习得了通用探索策略而非机械记忆 Schema。
进阶剖析
面对交互环境任务,该直接做强化学习(Direct RL)还是先做轨迹微调(SFT)?受控实验给出了清晰对比:
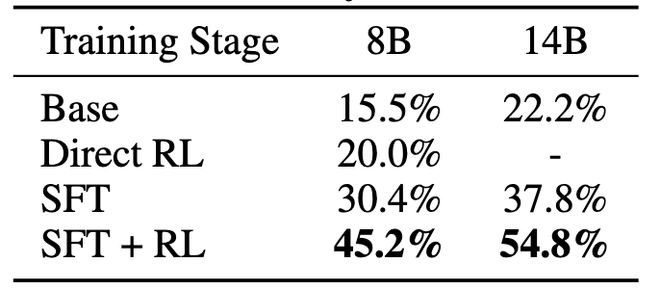
冷启动直接 RL 提升有限:8B 基座直接跑 RL 仅从 15.5% 微升至 20.0%(+4.5%)。缺乏交互先验时,稀疏二值奖励难以在长轨迹中有效分配信用。
全轨迹 SFT 奠定交互基础:经验证轨迹 SFT 后,8B 和 14B 分别跃升至30. 4%(+14.9%)与37. 8%(+15.6%),快速掌握了工具调用与报错纠偏规范。
SFT+RL 实现性能质变:在 SFT 基础上引入 DAPO 强化学习,8B 再涨 14.8% 达 45. 2%,14B 再涨 17.0% 达 54. 8%(增益达直接 RL 的 3 倍以上)。这确立了长程 Agent 的黄金范式:SFT 赋予交互框架与探索常识,RL 释放未知环境下的自适应寻优潜能。
四大消融实验
围绕长程 Agent 训练的关键设计选择,消融实验提炼出四项核心发现:
启示一:训练与推理接口的强对齐(Training-Inference Alignment)
若推理采用 DSH-SQL 交互环境,但训练使用非交互式(Non-harness)SFT 数据,Spider2.0 准确率仅9. 6%,甚至低于未微调基座(15.5%);而原生 HarnessSFT 达30. 4%。这证明:静态训练会破坏模型与动态环境的协作,训练与部署环境必须严格同构。
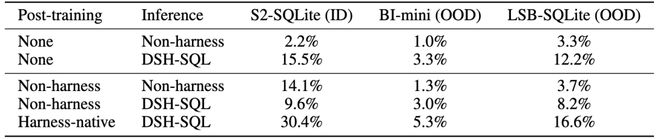
非交互式与原生 Harness 训练和推理在域内及域外基准上的交叉消融对比。
启示二:全序列轨迹组织显著优于单步拆解(Full-Trajectory>Turn-Split)
构建 SFT 数据时,保留完整轨迹上下文的全序列监督(Full-trajectory)在三大基准上全面优于单步拆解(Turn-split)。长程任务高度依赖前后多轮的因果脉络,拆碎样本会割裂全局决策连贯性。
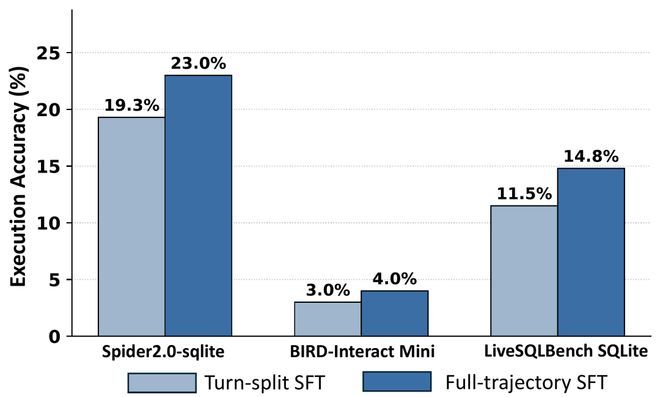
图3:全轨迹监督(Full-trajectory)显著优于单步拆解监督(Turn-split)。
启示三:超长上下文容量是长程探索的生命线(8K->16K->32K)
真实数据库探查伴随密集 Schema 与中间结果反馈,轨迹动辄上万 tokens。当训练与推理上下文从 8K 扩展至 16K 和 32K 时,Spider2.0 准确率从 27. 4% 跃升至 45.2%——截断早期历史等同于剥夺模型的复盘与溯源记忆。
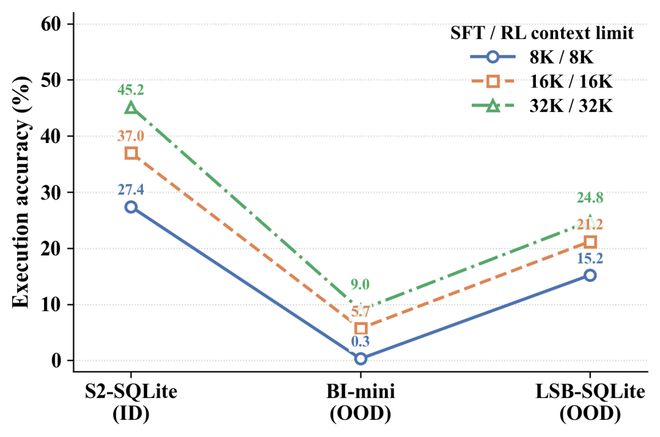
图4:上下文窗口长度对执行准确率的影响,32K 上下文带来显著提升。
启示四:DAPO算法更加契合稀疏奖励下的长程策略优化
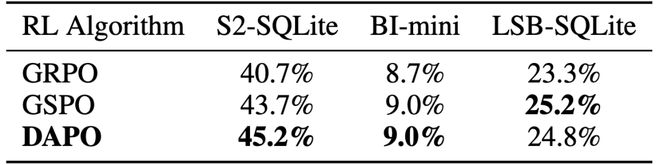
在相同预算与沙盒下对比 GRPO(40.7%)、GSPO(43.7%)与 DAPO(45. 2%),DAPO 表现最优。其动态过滤零方差轨迹组、解耦裁剪范围与全批次 token 归一化机制,有效缓解了稀疏奖励下的策略震荡。
值得关注的边界与未来演进
团队也客观指出了当前系统的演进方向:
1. 跨数据库方言扩展:从当前的 SQLite 生态进一步拓展至 Snowflake、BigQuery、PostgreSQL 等企业级云原生方言,构建更完善的权限隔离与生态适配。
2. 多模态与多元分析工具:除命令行查询外,进一步融合可视化图表、文档报告与交互式 BI 仪表盘等多元分析环境。
总结与展望
大模型正加速从「对话助手」走向「自主执行智能体」。HarnessSQL 证明:面对需要工具调用与试错反馈的复杂任务,仅灌输静态「正确答案」远远不够,必须将交互环境(Harness)纳入核心训练闭环,让模型在动态环境中原生习得长程探索与容错能力。
目前,HarnessSQL 的代码、沙盒环境与合成轨迹资产已全部在 GitHub 开源,为 Text-to-SQL、数据库智能体与通用 Agent 研发提供了可直接复用的标杆参考。
参考资料:
https://arxiv.org/abs/2610.12274
编辑:LRST
 科技
3000万招聘NPC、最高年薪千万,景区疯抢“打工人”
2026-10-08
 科技
QQ宠物登陆鸿蒙系统:会卖萌还会串门交朋友
2026-09-28
 科技
OpenAI开始断网训练最强模型:“安全起见”
2026-10-27