允中发自凹非寺
量子位 | 公众号 QbitAI
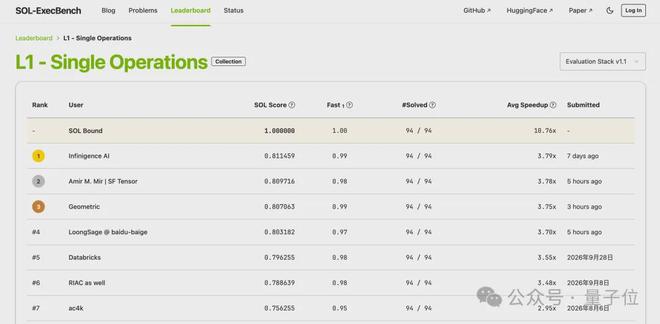
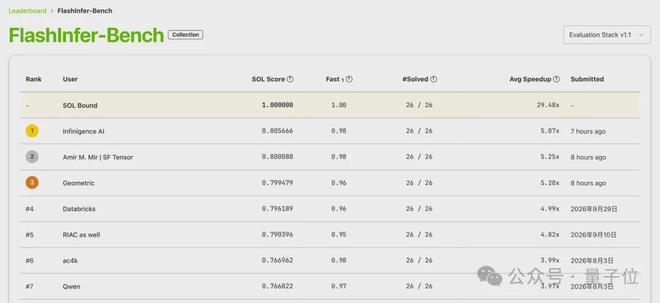
近日,在 NVIDIA Research 推出的 GPU 算子性能评测榜单 SOL-ExecBench [1] 上,无问芯穹(Infinigence AI)取得亮眼成绩:
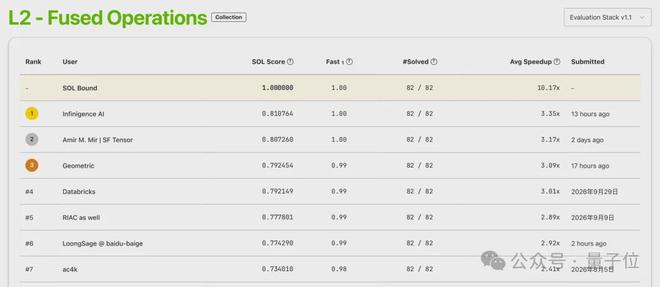
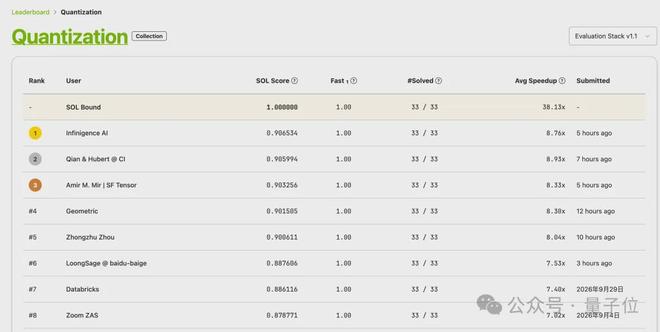
先后登顶 L1 基础算子、L2 融合算子、Quant 量化算子与 FlashInfer-Bench 推理算子全部四大赛道。
SOL-ExecBench 是什么?
SOL-ExecBench 是 NVIDIA Research 于 2026 年 3 月 19 日推出的算子优化 Benchmark。SOL 是 Speed of Light 的缩写,意为“光速”,在这里指代基于硬件能力推导出的理论性能边界。
与传统评测主要比较相对软件基线的加速效果不同,SOL-ExecBench 引入了以硬件性能上限为参照的 SOL Score,并在高性能计算卡上进行实际测试。
榜单包含从 124 个真实及前沿 AI 模型中提取的 235 道算子优化题目,覆盖语言、视觉、语音、视频及多模态等领域,并划分为四大赛道:
SOL-ExecBench 的一个突出特点是,从真实前沿模型的计算图中直接提取工作负载,并重点考察这些计算在新一代 GPU 上的性能极限
注:这是一个持续竞争、高频动态刷新的全球榜单。随着各支团队不断提交新的优化方案,排名也会随之变化,竞争十分激烈。
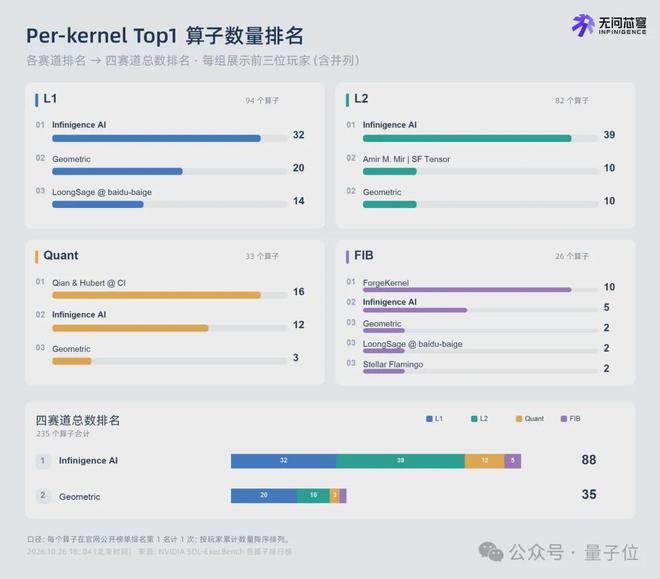
截至 2026 年 10 月 26 日,无问芯穹仍在 L1 与 Quant 两大赛道总分位列全球第一,L2 与 FlashInfer-Bench 赛道总分位列全球第二;在全部 235 道 GPU 算子优化题目中,以 88 项单题第一,位居所有参赛团队之首,超过第二名单题第一数量的 2 倍。
尤其是在考验复杂计算优化能力的 L2 融合算子赛道,无问芯穹拿下 82 道题目中的39 项第一,接近半数。
这场汇集全球顶尖 AI 基础设施和智能体研发力量的竞争,正在成为检验新一代 AI 算力优化能力的重要舞台。
从 GPU Maxxing 到 Token Maxxing,一场 AI 生产力转化的全球竞技
AI 生产力的价值落地,背后是一条“投入-电/卡-Token-生产力-价值”的完整转化链条。
在早期 Scaling Law 的推动下,投入更多计算资源,最大化 GPU 效率,是推动模型性能突破、提高 Token 生产的重要手段。
而随着 Agent 的发展,Token 成为任务执行的投入,而非最终交付物,模型可以通过更长的推理、更多轮的尝试和验证,突破原本难以解决的问题,但单纯增加 Token 投入却并不必然带来任务效果的提升。
如果始终重复相似的尝试,无法从执行反馈中修正方向,再多的 Token 也可能消耗在原地打转之中。
行业关注的核心正从 GPU Maxxing 进一步走向 Token Maxxing:不仅要提升从“电”到“Token”的转化效率,还要让更多 Token 真正转化为模型能力与任务成果,实现从“Token”到“生产力”的高效转化。
SOL-ExecBench 为检验这一能力提供了具体场景。它从真实前沿模型中提取计算负载,覆盖基础算子、复杂融合、低精度计算与推理优化,要求提交的代码同时满足正确性与性能要求。在这里,Agent 需要经历代码生成、编译运行、性能分析与反复调优,其工作成果最终由真实硬件上的执行结果衡量。
这一评测吸引了包括全球数据与 AI 平台企业 Databricks、Y Combinator 孵化的 AI Infra 创业公司 SF Tensor、知名 AI 编程工具团队 Cursor,以及 Recursive、doubleAI、Geometric 等活跃于自动化算子优化领域的技术团队参与。
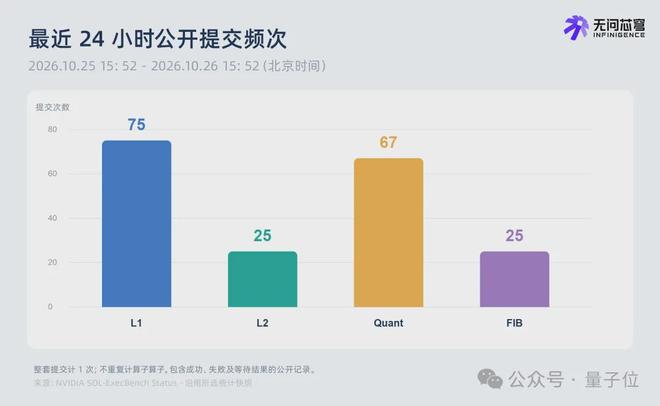
据 SF Tensor 于 2026 年 9 月 25 日公布的数据,当时已有 583 支团队累计提交超过 3.1 万次评测,以平均约每 8 分钟一条公开提交的高频次,持续推动榜单刷新。
众多参赛团队借助 Agent 自动生成、测试和优化底层计算代码,使这场竞赛既考验 GPU Kernel 优化水平,也考验如何将模型能力组织成能够持续完成复杂工程任务的系统。
在这样激烈的全球竞逐中,无问芯穹先后取得 L1、L2、Quant 与 FlashInfer-Bench 四大赛道全球第一。
既体现了团队在算子优化与软硬件协同方面的技术积累,也检验了团队通过 Agentic Infra 将 Token 投入转化为经过验证的计算性能收益,并以此探索 AI 自主完成复杂任务的有效路径的能力。
以 AI 生产力反哺 Infra 进化,以技术实践助力 RSI 工程化落地
从资源投入到 Token 生产,再到实际生产力的交付与价值兑现,无问芯穹 Agentic Infra 始终致力于推动这条链路从单向推进走向闭环进化。
团队希望让 Agent 不仅消耗 Token 完成任务,更能够将创造的生产力反哺于基础设施本身,持续提升 Token 的生产,探索 AI 基础设施 RSI 的实现路径。
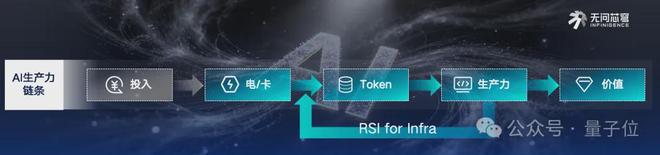
算子优化任务,为探索这一过程提供了具体切入点:GPU Kernel 的执行效率直接影响硬件性能的发挥;Agent 找到的高效实现,在经过验证并应用于训练与推理系统后,有望进一步降低计算开销,让算子优化的收益延伸至 Token 的生产环节。
沿着这一方向,首先需要解决的是如何让 Agent 持续产出可靠的优化成果。代码能否正确执行、性能瓶颈在哪里、一次修改是否带来了真实收益,都需要通过实际运行来判断,并成为下一轮探索的依据。
为此,无问芯穹围绕 SOL-ExecBench 构建了一套算子优化 Agent,将代码生成、执行验证、性能分析与经验积累组织成连续的工作流程。
下面将从容器隔离执行、Skills 感知与共享 Memory,以及面向不同任务的优化策略这三个方面,介绍无问芯穹具体如何支持 Agent 在真实硬件反馈下实现持续改进。
容器化隔离架构
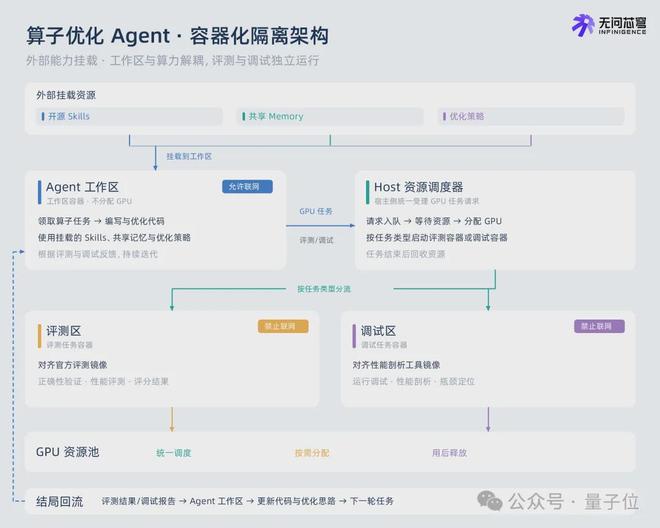
在执行架构上,系统采用容器化隔离,将 Agent 工作区、评测区与调试区解耦。Agent 在允许联网、不直接分配 GPU 的工作区中,通过外部挂载加载 Skills、共享 Memory 与优化策略,完成代码编写并提交计算请求。
宿主侧资源调度器统一管理 GPU,对请求进行排队与按需分配,分别在与官方评测环境对齐的镜像、集成性能剖析工具的镜像中执行评测与调试。两类执行容器均禁用网络访问,结果回传至 Agent,形成“代码生成—评测验证—性能分析—策略调整”的迭代闭环。
这一隔离设计服务可以防止 Agent 在自动优化过程中绕过评测约束。当 Agent 以性能指标为优化目标时,其探索可能偏离算子实现本身,转而尝试修改评测脚本、干预计时逻辑、访问参考结果或利用环境漏洞,获得并非来自真实计算效率提升的分数。容器隔离、权限控制与受控提交接口共同构成执行边界,使 Agent 能够持续优化候选算子,同时限制其对评测过程本身的干预。
模块化 Skills 与共享记忆机制
在 Agent 能力构建上,系统不仅通过模块化 Skills 接入开源社区的技术积累,还通过专门的框架感知 Skill,帮助 Agent 理解并使用相关框架,同时利用共享 Memory 持续沉淀与复用优化经验。
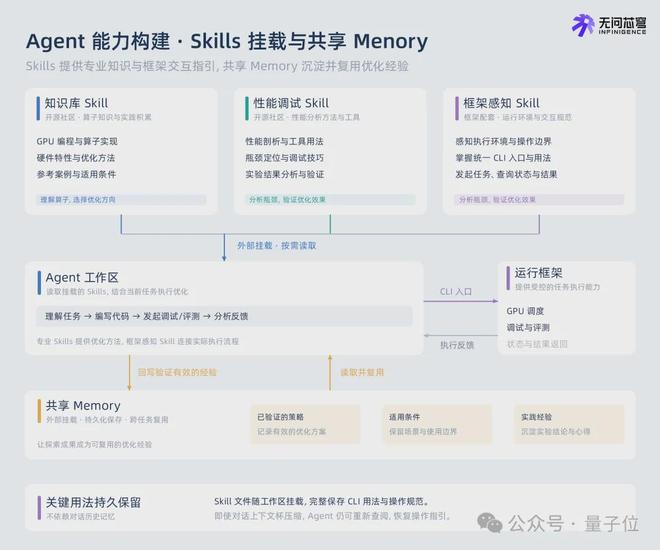
这些机制共同驱动 Agent 调用专业能力、正确使用运行框架,并在持续迭代中积累经验、减少重复探索。
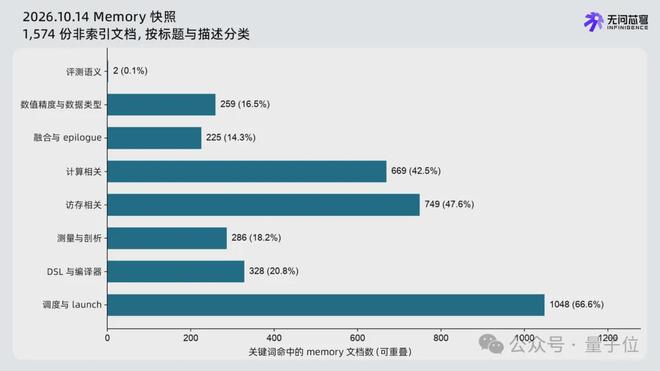
△共享记忆的沉淀
针对任务特征的精细化优化策略
在优化策略上,系统围绕工作负载特征、性能瓶颈与时间预算,组织分层探索。
系统引导 Agent 根据优化时间预算选择合适的编程抽象与 DSL(领域特定语言),在 Triton、TileLang、CuTe DSL 等不同粒度的 DSL 之间权衡开发效率与性能潜力,并通过逐层生成低层语言(如 CUDA、PTX),持续挖掘硬件性能空间。
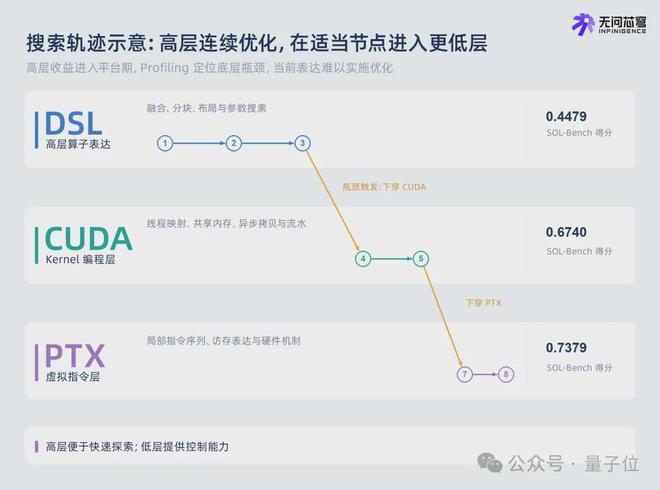
△图片仅为实例案例,并非大规模消融实验结果
针对不同计算场景,优化策略进一步细化:
通过开放能力复用、分层性能优化与真实硬件反馈的结合,无问芯穹希望将高度依赖专家经验的 GPU 算子调优,转化为 Agent 可以自主探索、持续学习和规模化执行的优化过程。
以持续创新的 Agentic Infra ,拓展智能进化边界
SOL-ExecBench 的成果并非一次孤立的技术突破,而是无问芯穹长期深耕 Agenetic Infra 技术创新的自然延伸。
从连接“M种模型”与“N种芯片”,到以“多元异构、软硬协同、自主式 AI”为核心的“前店后厂一中心”的 Agentic Infra 战略布局,无问芯穹始终围绕 AI 生产力链条的核心环节展开技术探索与实践。
此次在 SOL-ExecBench 上的探索与成果,不仅是其长期技术路线在底层计算优化领域的阶段性体现。更重要的是,其证明了将这种效率优化能力进一步交给 AI 本身这一 RSI 路径的可行性,初步实现了从 Token 生产到生产力创造,再由生产力反哺 Infra 的进化闭环。
下一步,无问芯穹希望将这一探索延伸至 Agent 自身的任务执行框架。通过修改和验证任务规划、工具调用、记忆管理与反馈机制,让 Agent 在完成任务的过程中,逐步改进自己解决问题的方法。
当优化成果不仅能提高计算效率,还能改善产生优化方案的机制,持续探索就有机会转化为持续的能力增长。
面向 RSI 与 AGI 的未来演进,在充满信心的同时,无问芯穹的技术团队也清醒地认识到,单点技术突破距离真正的系统级能力仍有很长的路要走,要让局部优化真正转化为实际的生产力,同样也需要更多的技术探索与协同。
从让 AI 更高效地使用算力,到让 AI 参与算力系统自身的优化,无问芯穹正持续推动基础设施从支撑 AI 创新,走向与 AI 协同进化,为有效 AI 生产力的持续交付探索新的路径。
致谢:
Humanize 社区(https://github.com/humanfia/humanize)
参考文献:
[1] SOL-ExecBench: Speed-of-Light Benchmarking for Real-World GPU Kernels Against Hardware Limits. 2026. https://arxiv.org/abs/2603.19173
[2] KernelBench: Can LLMs Write Efficient GPU Kernels? ICML 2025. https://arxiv.org/abs/2502.10517
[3] MultiKernelBench: A Multi-Platform Benchmark for Kernel Generation. 2025. https://arxiv.org/abs/2507.17773
[4] CANN Bench: Benchmarking Agent Generated Kernels against Real NPU and Algorithmic Limits. 2026. https://arxiv.org/abs/2607.20518
 科技
3000万招聘NPC、最高年薪千万,景区疯抢“打工人”
2026-10-08
 科技
QQ宠物登陆鸿蒙系统:会卖萌还会串门交朋友
2026-09-28
 科技
OpenAI前大牛认错!误判AI近十年,90%神经元只干一件事
2026-10-21