允中发自凹非寺
量子位 | 公众号 QbitAI
传统抗体发现通常依赖动物免疫,或从大规模抗体文库中“地毯式搜索”。
分子之心最近发布的一份技术报告,却给出了一个不太一样的答案。
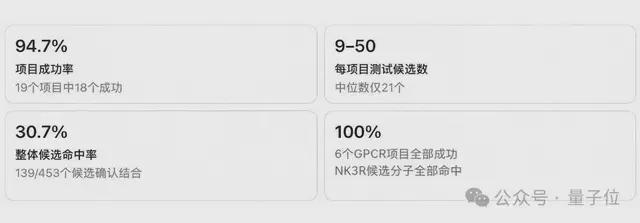
这份关于其 AI 蛋白质从头设计平台 MMDesign 的最新技术报告,覆盖 18 个不同靶点、纳米抗体(VHH)和大环肽两类分子模态共 19 个设计项目:
这些数字共同指向着 MMDesign 已经从“技术突破”进入“系统性验证”阶段:同一套“生成-筛选-验证”工作流能在跨靶点、跨模态的项目中,以少量候选分子反复通过湿实验验证。
半年内三次迭代的 MMDesign,试图把“高效命中”变成一种可以重复的能力。
对 AI 制药来说,真正的看点不止一个层面:
生成之后,送入实验室测试的候选分子能不能少一点、命中率能不能高一点,这是效率。
候选分子的亲和力、可开发性指标和新颖性能不能好一点,这是质量。
还有一点同样关键,生成过程不依赖任何已知结合分子做参考改造,直接从功能需求出发设计出分子,即使面对没有先例可循的靶点,也能给出答案,这正是从头设计区别于“改造已知分子”的本质价值。
先把“海选”搬进计算机:单项目只测几十个分子即获命中
AI 从头设计可以跨过在大规模文库里反复摸索的传统发现路径,由研发人员指定目标靶点和结合表位,让 AI 在计算空间直接生成分子序列。
但生成序列只是起点,从数万条候选里,能够精准挑出值得进实验室的那几十个,才是真正的分水岭。
MMDesign 把这一过程固定成“生成-筛选-验证”的统一工作流:
先在计算空间生成数万个候选,再经结构可靠性、序列天然性和基于统计物理的多层评估,把单一项目的候选集合压缩到仅9-50 个,中位数仅 21 个。19 个项目 18 个获得可结合分子,项目成功率达 94.7%,全部 453 个受测候选中,139 个获得确认结合,整体候选命中率 30.7%。
这里有两把尺子,口径不同但都重要:94.7% 衡量的是“一个项目能否找到至少一个结合分子”,30.7% 衡量的是“受测候选中有多少真正命中”。就从头设计而言,放眼全球这两个数字都已相当亮眼。
15 个项目至少拿到两个结合分子,占全部项目近八成,意味着研发团队不只“有得用”,还能在多个候选之间比较、优化。
对药企来说,计算端把低价值候选尽早排除,实验资源就能集中押注在高潜力分子上,这是从“海量筛选”转向“精准设计”的真正价值。
六个 GPCR,一个都没掉链子
如果说 94.7% 展示的是效率,GPCR 系列则直接测试技术成色。
GPCR 是制药业最重要的药物靶点家族之一,但针对它设计抗体一直是个难题。
一方面,GPCR 作为膜蛋白,结构复杂、构象多变;另一方面,暴露在细胞外、可供抗体结合的区域又十分有限。这些特点让 GPCR 成为抗体从头设计领域公认的“硬骨头”。
报告显示,MMDesign 针对 CCR7、CCR8、EP2、GPR68、NK3R、A2AR 六个 GPCR 靶点开展从头设计,全部成功获得实验确认的结合分子。
在报告所用 BLI 检测条件下,各靶点候选命中率介于 12.1% 至 100%,六个靶点最优结合分子的亲和力均达纳摩尔级,GPR68 最优 KD 低至 12.1 纳摩尔。
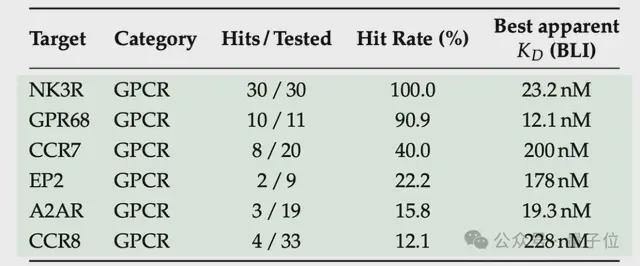
两组结果尤其醒目:NK3R 的 30 个受测候选全部确认结合,命中率 100%;GPR68 的 11 个候选中 10 个命中。
更进一步的证据来自“无先例”场景:
在 Thera-SAbDab 数据库(PL132)中检索查无已编目治疗性抗体先例的 5 个 GPCR 靶点上,89 个受测设计中有 53 个获得结合,候选命中率达 59.6%。
这正是从头设计和“基于先例改造”的分水岭:AI 必须仅凭靶点结构与功能需求“闭卷作答”。
59. 6% 的候选命中率说明,即便没有“参考答案”,平台照样能在复杂膜蛋白靶点上开辟新的发现路径,为突破传统研发难点问题提供可能。
跨轮次能优化,跨模态可拓展
药企和平台长期合作,真正看重的是“能不能重复用”:有了初步设计后还能不能优化?换了任务还能不能成功?
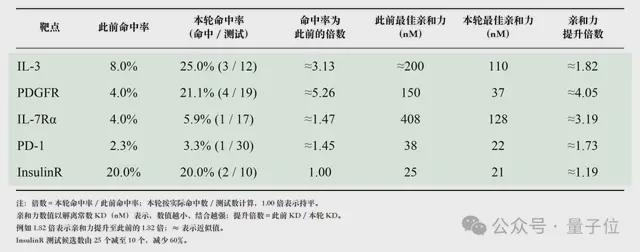
本次报告给出了肯定答案:MMDesign 对 6 个此前已有结合分子的靶点再进行了一轮设计,其中 5 个在命中率、最佳亲和力或两者上获得了进一步提升。
以 PDGFR 为例,候选命中率由 4.0% 升至 21.1%,最佳 KD 由 150 纳摩尔优化至 37 纳摩尔,对应 4 倍的亲和力提升。同一个研发问题,再来一轮还能拿出更优分子。
平台的适用范围也延伸到不同的分子模态:大环肽设计结果显示,MDM2 项目 21 个候选中 16 个命中,命中率 76.2%,最佳 KD 为 13.7 微摩尔;PD-L1 项目 28 个候选中 11 个命中,最佳 KD 为 40.2 微摩尔。
和纳米抗体相比,大环肽构象受环状骨架约束,设计难点不同,但同样跑通。
这套“生成-筛选-验证”能力,正在向不同的设计任务复用。
跨轮次的设计优化、跨模态的工作流复用,共同构成系统性验证的一体两面:
平台的能力,正在从“单点成功”走向“体系化输出”。
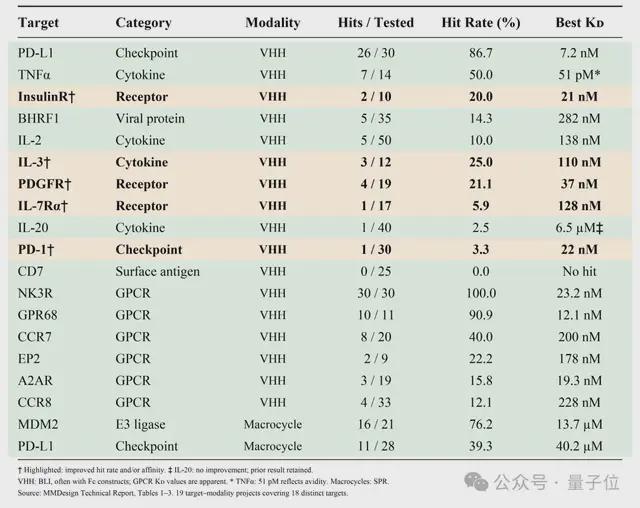
△验证结果汇总
“能结合”是入场券,可开发性与新颖性也需要闯关
对药物发现来说,“能结合”算拿到了入场券,但一个真正有价值的早期命中分子,还要过后面几道“关口”:
能不能稳定表达、会不会聚集、有没有乱结合无关蛋白。
报告显示,MMDesign 已经把这类问题前移到设计评估环节:部分 VHH-Fc 候选在 10 毫升培养规模的 CHO 细胞表达实验中表现出良好的表达水平;许多纯化后的候选以非聚集的主峰组分为主,聚集迹象很少;受测候选子集对胰岛素和双链 DNA 两种替代抗原的非特异性反应也较低。
平台在追求结合活性的同时,已经将分子进入后续药物开发所需的关键性质纳入考量。
序列新颖性更是“无参考答案设计”的直接证据。
MMDesign 的生成过程不依赖从抗体序列数据库检索已知结合分子作为改造起点;与 PDB、OAS 及 SAbDab 等数据库的比较显示,多个靶点的设计分子在抗原识别区域与已知抗体存在显著差异,部分分子的关键结合环区 CDR3 呈现新颖构象。
平台产出的候选,不是对已知分子的“临摹”,而是围绕功能需求产生的新序列,直指传统研发难以攻克的难题,也给绕开已有专利布局、拓展全新候选空间提供了可能。
两倍于 AlphaFold 3 的高精度结构预测,与它背后的“AI 生物新基建”
从头设计要想“选得准”,结构预测得先“看得准”。
分子之心自研的全原子结构预测模型 MMFold,就是 MMDesign 背后的结构底座。
在国际权威的 FoldBench 抗体-抗原复合物结构预测基准上,MMFold 在全部 172 个界面的评测中,Top-1 高质量结构预测成功率达 39.0%,约为 AlphaFold 3 对照结果 19.8% 的两倍;
Top-1 整体成功率达 70.9%,Top-5 整体成功率进一步达 76.7%,其中高质量预测成功率 44.2%。
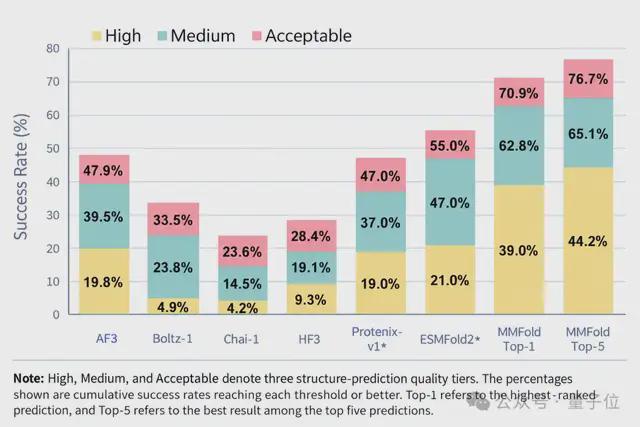
△FoldBench 全部 172 个抗体-抗原界面结构预测结果
在与 OpenDDE、Protenix-v2 公开结果对应的 160 个共同界面子集上,MMFold 的 Top-1 高质量成功率达 39.4%,高于 OpenDDE 报告的 33.0% 与 Protenix-v2 报告的 28.2%;Top-5 高质量成功率进一步达 45.0%,整体成功率 78.8%。
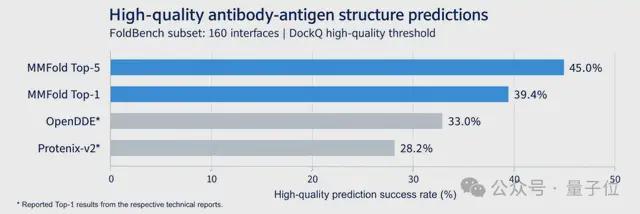
△FoldBench 的 160 个共同界面子集结构预测结果
结构预测的价值不在排名本身,而是让候选分子的评估与优选有了更扎实的计算依据。
结构看得更准,分子设计者才能更快从庞大的计算空间里锁定少数值得实验的候选。
支撑整套“AI 生物新基建”的,是分子之心围绕蛋白质生成、结构预测、分子设计与动态模拟构建的自主 AI 技术版图:
多模态蛋白质基础大模型 NewOrigin(达尔文)提供底层能力,MMDesign 承担从头生成与候选优选,MMFold 专注结构预测,QuantaMind 进行动态模拟,AI 原生研发操作系统 MoleculeOS 则把模型工具与研发流程串成“生成-计算-实验-迭代”的闭环。
从“命中”到“可复用”,让 AI 分子设计进入真实研发
分子之心创始人许锦波表示:
这次扩展评估的重要意义,在于将一次性的设计成功,逐步转化为可重复、可扩展的研发能力。AI 生物药研发的长期价值,不只是单个模型的性能突破,更在于通过自主底层模型与生成、评估、实验验证的协同,让精准分子设计成为能够持续解决不同研发问题的技术基础设施。
从单点命中到跨靶点、跨模态的系统性验证,从底层模型突破到可复用的研发工作流,MMDesign 的最新报告把“AI 能不能设计出分子”的问题,推进到了“AI 能不能稳定、可复用地产出可用分子”。
少量候选、稳定命中的设计效率;亲和力、可开发性与新颖性并重的分子质量;不依赖“参考答案”、从功能需求直接给出分子、成功拿下高难度靶点的突破价值。三者共同支撑起“可复用”能力,让 AI 分子设计可以被产业持续用于解决真实研发需求。
分子之心 MMDesign 技术报告:
https://zenodo.org/records/23321531
*本文系量子位获授权刊载,观点仅为原作者所有。
 科技
3000万招聘NPC、最高年薪千万,景区疯抢“打工人”
2026-10-08
 科技
QQ宠物登陆鸿蒙系统:会卖萌还会串门交朋友
2026-09-28
 科技
OpenAI前大牛认错!误判AI近十年,90%神经元只干一件事
2026-10-21