文 | 斯凯有话说
2026 年 10 月 16 日,vLLM 官方博客发布了一篇技术复盘,标题很技术流:《Hyper Optimizing Kimi K3 in vLLM: Moving Fast and Responsibly》。
署名作者是英伟达 CentML 的工程师 Benjamin Chislett。他做了一件事:用一段 1.2 万行 CuTe DSL 编写的 Megakernel,将月之暗面 2.8 万亿参数的 Kimi K3 推理速度大幅提升。据 SemiAnalysis 测算,在相同的 GB300 NVL72 硬件上,K3 达到 423 tok/s/user 的推理速度,性能提升 1.68 倍。vLLM 博客原文报告的数据则是:batch 1 下超过 840 tokens/s,多个测试配置下解码吞吐提升 1.5—2 倍。
没有换一张卡。没有上更先进的制程。没有等下一代芯片。
但真正让这件事值得深挖的,不是那 1.68 倍。
是博客里的一句话,被绝大多数中文报道忽略了:
“Agent-optimized inference code is outpacing our review and maintenance workflow.”
智能体优化的推理代码,正在超过人类团队的审查和维护速度。
这句话翻译成大白话就是:AI 写的代码,人类来不及审了。
一个工程师、1.2 万行代码、AI 辅助开发
先看技术层面发生了什么。
Kimi K3 不是普通模型。它的 Stable LatentMoE 架构有 896 个专家,每次推理激活 16 个。这种极端稀疏的 MoE,在训练端是“用更少激活参数撬动更大容量”的利器,但在推理端是工程噩梦。据 SemiAnalysis 分析,K3 一次前向计算的 HBM 带宽需求约 1.5TB,每次前向触发超过 120 次 All-to-All 通信。解码阶段是典型的内存带宽受限场景,计算单元大部分时间在等数据搬运。
传统推理引擎的解码过程,由一连串独立内核完成:注意力一个、MoE 路由一个、专家计算一个、通信一个。每一个内核启动有开销,每一次内核间数据交换要经过显存读写。
Megakernel 的核心思想是算子融合:把分散的解码内核合并成一个高度融合的超级内核,减少启动开销、合并内存访问、让计算和通信尽可能重叠。
1. 2 万行代码的含金量,是把“通用硬件跑通用模型”的默认效率,替换成了“专用硬件跑专用模型”的极致效率。硬件没变,模型没变,变的是“数据在硬件上怎么走”。
而写这 1.2 万行代码的过程,本身就是一个信号。vLLM 博客明确写道:“Coding agents can now help with some of the hardest parts of model optimization: writing complex GPU kernels, performing cross-operator fusions, overlapping computation with communication, and tuning execution across different batch sizes and GPU configurations.”团队“使用了智能体辅助开发来构建统一的 CuTe DSL 解码路径”。
这不是“AI 独立写完了全部代码”。人类工程师 Benjamin Chislett 是项目的主导者和架构设计者。但在最困难的部分——复杂 GPU 内核编写、跨算子融合、通信重叠、不同批次和 GPU 配置下的调优——AI 承担了相当大的工作量,以至于人类的逐行审查跟不上了。
“来不及审”意味着什么
博客里还有一个细节,中文报道几乎没有提及。
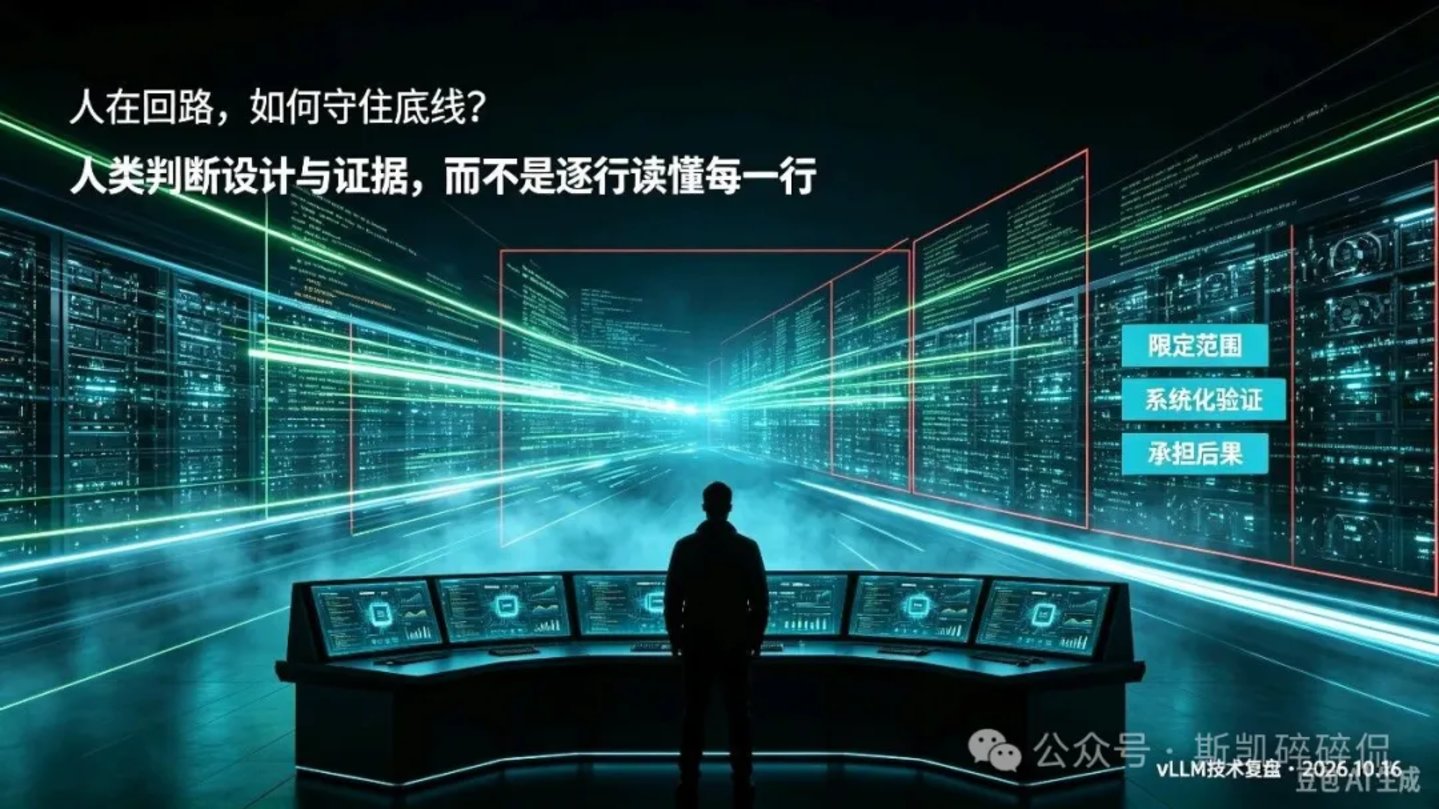
vLLM 团队为了应对这个局面,发布了一个 fast-track model optimization RFC。核心思路不是“让人类审得更快”,而是改变性能工作的组织方式。博客原文列出了四条原则:Isolate changes(隔离变更)、Bound the scope(限定范围)、Validate correctness systematically(系统化验证正确性)、Scale validation(扩大验证)。
更重要的是这句话:“Human reviewers still judge the design and the evidence, but they can start from a high-level abstraction, instead of a line-by-line code review.”
人类审查者仍然判断设计和证据,但他们可以从高层抽象开始,而不是逐行审代码。
翻译一下:人类从“写代码的人”变成了“设计验证框架和风险边界的人”。
AI 写代码,人类管流程。这不是未来,这是 2026 年 10 月 16 日 vLLM 博客里写着的现状。
这件事的分量,需要放在一个更大的背景里看。
你之前写过“AI 攻击联合国网站”“AI 研究员辞职警告”“AI 差点引发中美冲突”。那些故事里,AI 是“行为的主体”——它做了人没让它做的事。而这次不一样。这次是 AI 成了“优化的主体”——它在帮人写代码,让另一个 AI 模型跑得更快。
区别在于:前者是人类要“管住”AI,后者是人类要“跟上”AI。管住,是控制边界的问题。跟上,是能力速度的问题。
当 AI 生成代码的速度,超过了人类审查代码的速度,“人类在回路中”这个原则,就面临一个非常具体的挑战:回路上的人类,还能不能看懂回路里的东西?
为什么解码优化比训练优化更难
要理解这 1.2 万行代码为什么值钱,得先理解 K3 的推理为什么难。
训练是“算力峰值受限”——你有多少 FLOPs,就能跑多少计算。解码是“内存带宽受限”——计算单元大部分时间在等数据搬运。K3 的 896 个专家被分布到多张芯片上,每处理一个 token,路由系统要把数据分发到被选中的专家所在芯片,再把结果收回。超过 120 次 All-to-All 通信,每一次都是延迟。
所以在这个场景里,“换更快的芯片”不一定是最高效的解法。瓶颈不在算力峰值,在数据流动的效率。Megakernel 的算子融合,本质上是在减少数据在显存和计算单元之间来回搬运的次数。
这个技术判断的产业含义是:当制程红利放缓,当单卡峰值性能追赶需要以年为单位计算,“让已有硬件跑出更高有效算力”正在成为回报率更高的路径。
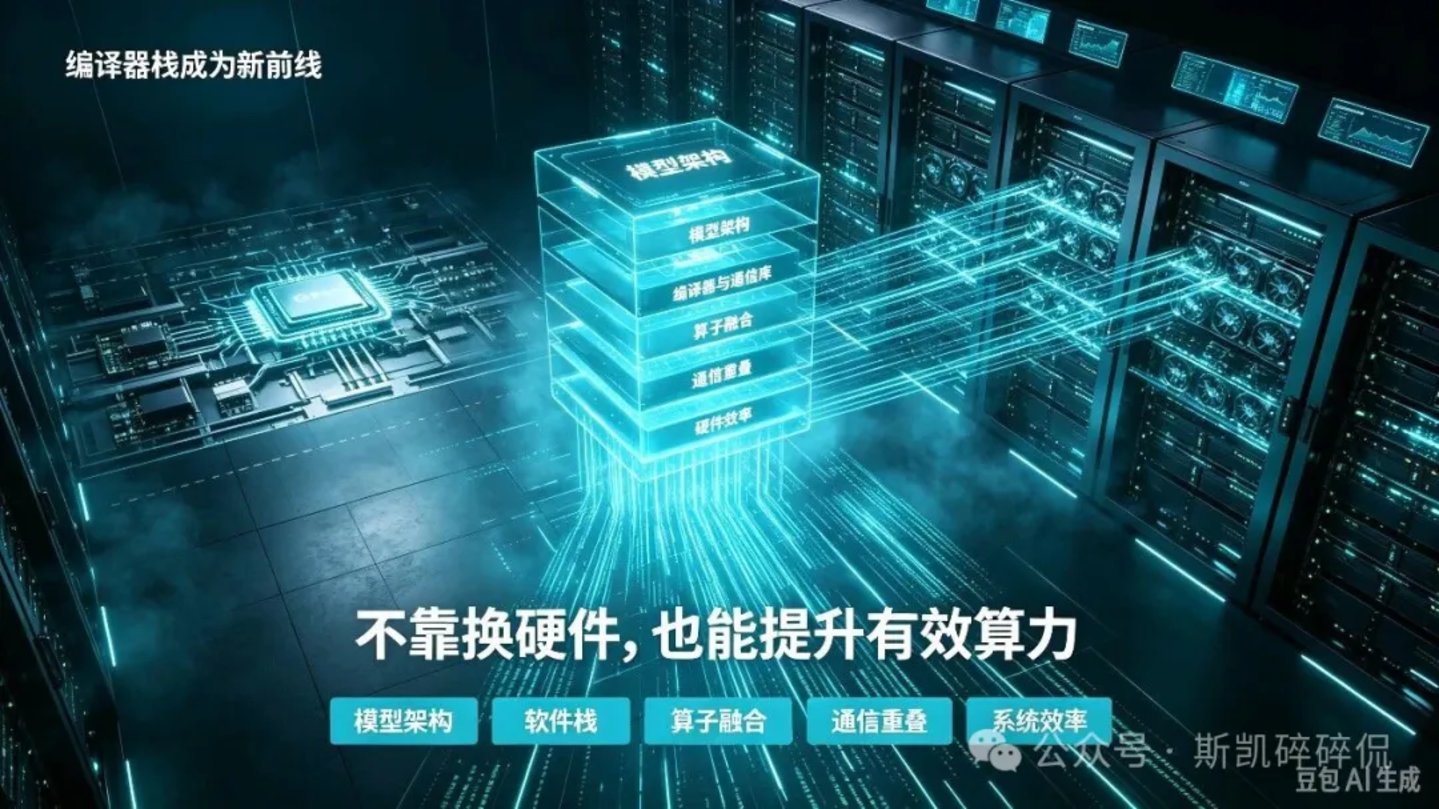
编译器栈,正在成为算力竞争的新前线
SemiAnalysis 创始人迪伦在红杉专访中有一个判断:“性能提升绝不能单靠硬件堆砌。模型架构、软件栈(编译器与通信库)与底层硬件的深度协同优化,才是实现百倍效率飞跃的真正突破口。”
这句话对理解英伟达这 1.2 万行代码的意义,比任何单一的性能数字都重要。
在先进制程芯片获取受限的背景下,单卡性能差距短期难以抹平。但系统效率、编译器优化、算子融合、通信重叠——这些是纯软件层面的工程能力,不依赖晶圆厂,依赖工程师和工具链。英伟达用一个工程师、1.2 万行代码、AI 辅助开发,在不换硬件的前提下拿到了显著的效率提升。这个事实本身就在提示:算力竞赛的维度正在分裂。一条线是“造出更强的芯片”,另一条线是“让现有的芯片干更多的活”。后一条线,对追赶者门槛更低,空间更大。
IT 之家的报道提到,英伟达“还在为 vLLM 开发 DeepSeek V4.1 等其他模型的优化”。这意味着 Kimi K3 的优化不是一次性的炫技,是一套可复用的方法论正在向更多中国模型扩散。
英伟达在帮中国模型“榨干”它自己卖的硬件
这里有一层微妙的关系值得点一句。
英伟达优化的是月之暗面的 Kimi K3,还在优化 DeepSeek V4.1。在芯片管制的背景下,英伟达的软件团队正在为中国模型“榨干”它自己卖的硬件。
卖铲子的人,在帮你磨铲子。这既是因为软件优化能拉动硬件销售,也是因为英伟达需要证明:即使在管制框架下,它依然是中国 AI 产业不可或缺的一环。这个关系里,竞争与合作是同时存在的。
写在最后
回到那句“来不及审”。
这件事真正的分量,不在于英伟达优化了 Kimi,不在于 1.68 倍,甚至不在于“编译器栈成为新前线”。
在于它提出了一个人类必须回答、但目前还没有答案的问题:当 AI 开始优化 AI,而且优化的速度超过了人类理解的速度时,人类还能不能守住“最终判断权”这条底线?
vLLM 团队的答案是“改变组织方式”——不逐行审,而是设计验证框架、限定变更范围、系统化测试。博客里还披露了一个细节:审计发现编译器把激活读取移到了同步等待之前,修复方案是把这种加载类型限制为静态权重。这类错误能通过简单的功能测试,需要针对性的调查才能发现。这个答案务实,但它本质上是在说:我们接受“看不懂每一行代码”这个现实,然后用流程来兜底。
这可能就是 AI 时代“人在回路中”的新形态。不是“人看懂一切”,而是“人定义边界、设计验证、承担后果”。
技术可以加速,但判断不能外包。这句话在“AI 写代码优化 AI”的场景里,有了一个新的含义:判断不一定看得懂代码,但必须看得住风险。
vLLM 的博客标题里有“Responsibly”这个词。在一个 AI 生成代码速度超过人类审查速度的时代,“负责任”这三个字的分量,比 1.68 倍重得多。
AI 开始自主优化 AI、代码迭代速度碾压人类审核能力,算力竞争正式从「拼硬件」迈入「拼软件栈、拼人机治理」的新时代。未来不会是人类淘汰 AI,而是跟不上 AI 迭代节奏的人,会被行业淘汰。
你认为:当 AI 写代码的速度超过人类审查的速度,你觉得“人在回路中”还守得住吗?人类放弃逐行审代码、靠框架兜底风险,真的能守住 AI 的最终控制权吗?关注我,评论区聊聊你的看法。
 科技
3000万招聘NPC、最高年薪千万,景区疯抢“打工人”
2026-10-08
 科技
QQ宠物登陆鸿蒙系统:会卖萌还会串门交朋友
2026-09-28
 科技
OpenAI开始断网训练最强模型:“安全起见”
2026-10-27