
10 月 30 日消息,谷歌研究团队于 10 月 27 日发布博文,介绍一项名为“睡眠框架”(Sleep Framework)的持续学习研究成果,试图解决大语言模型发布后知识固化、难以吸收新信息的难题。
该研究已于 10 月 27 日由 Google Research 公开,相关论文题为《Language Models Need Sleep: Learning to Self-Modify and Consolidate Memories》。
谷歌指出在通常情况下,当前主流大模型在完成预训练后便进入相对静态的部署状态,其知识存在“截止日期”;若依赖上下文学习,新信息又会随会话结束而丢失。若直接用新数据反复微调,则容易引发“灾难性遗忘”,而模型学会新知识后,原有能力显著下降。
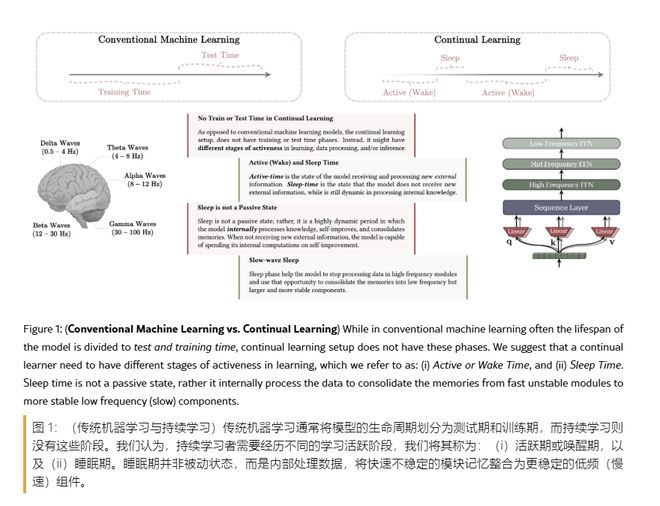
谷歌介绍一项名为“睡眠框架”(Sleep Framework)的持续学习研究成果
谷歌的方案借鉴人类睡眠中的记忆巩固机制,将模型运行划分为“清醒阶段”和“睡眠阶段”。清醒时,模型接收并处理输入,将信息暂存于短期记忆;进入睡眠阶段后,模型暂停处理新输入,转而进行记忆整合与自我改进。
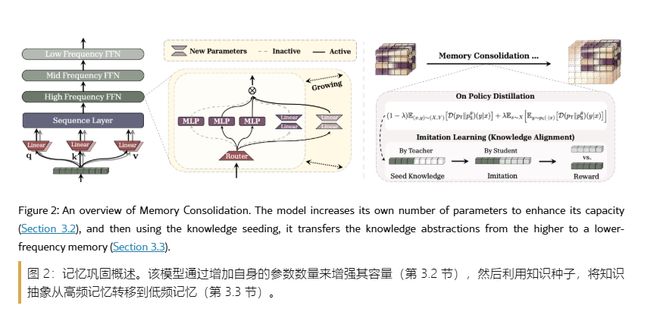
谷歌的方案借鉴人类睡眠中的记忆巩固机制
具体而言,“记忆巩固”环节通过参数扩展、混合专家记忆块和知识蒸馏,把脆弱的短期上下文信息写入长期参数,同时避免覆盖既有知识;“做梦”环节则让模型生成并筛选合成训练样本,借助强化学习反复练习,以提升推理与泛化能力。
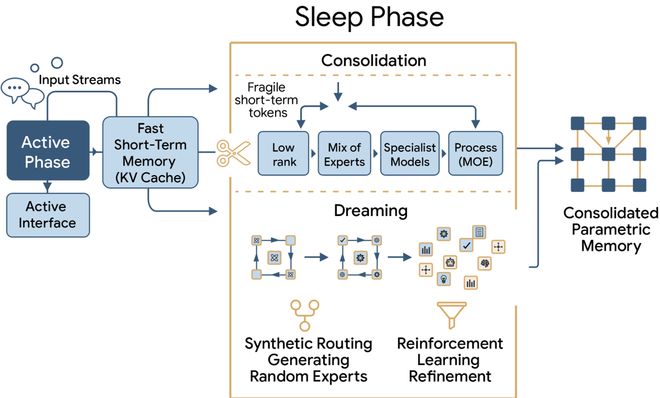
“做梦”环节则让模型生成并筛选合成训练样本
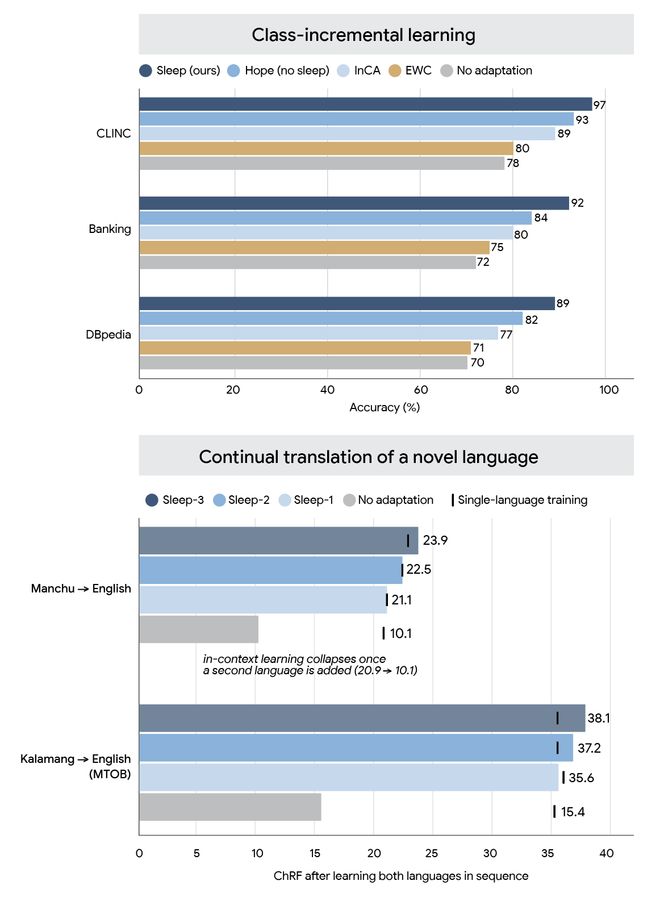
实验显示,该框架在持续翻译、长上下文理解、事实知识吸收和数学推理等任务中优于多种基线方法:模型可处理最长约 1000 万 token 的上下文,并在未见语言的多阶段持续学习中保持接近零的性能下降;在 AIME 24/25 等数学基准上也取得更高准确率。
 科技
3000万招聘NPC、最高年薪千万,景区疯抢“打工人”
2026-10-08
 科技
QQ宠物登陆鸿蒙系统:会卖萌还会串门交朋友
2026-09-28
 科技
OpenAI前大牛认错!误判AI近十年,90%神经元只干一件事
2026-10-21







 今天吃什么?
 关于我们