新智元报道
在 13 类复杂的算法任务、26 次独立运行中,一个全新的神经网络在隐藏测试集上全部达到了 100% 的准确率。
更不可思议的是,整个过程没有喂给它海量数据,甚至完全没有使用「反向传播」和「梯度下降」。
这个晶莹剔透、小巧至极的满分神经网络,是 Claude Opus 5.5,用代码一行一行直接「手写」出来的。
近日,微软研究院联合约翰斯·霍普金斯大学、哥伦比亚大学和纽约大学的团队,发表了新研究「可解释权重空间编程(iWSP)」。
这项研究证明:前沿大语言模型已经可以直接越过传统的优化器,依据固定的评测反馈,像外科医生一样精准构思计算逻辑,并用代码将算法直接写进 Transformer 的权重里。
不用反向传播,AI 直接当起「钟表匠」
深度学习常被戏称为「炼丹」。
整个过程,就像一群盲人围着一台布满几亿个旋钮的巨大控制台,谁也看不见里面长什么样,只能凭机器偶尔发出的「报错声」,摸索着拧这个、转那个。
几万步迭代下来,机器居然真就正常运转了,某些任务甚至比人类自己还高,堪称「原地飞升」。
可你要是追问一句:哪个旋钮管逻辑?哪个旋钮管记忆?没人答得上来。
总之,效果拔群,原理不详——旋钮拧对了是玄学,拧错了是事故,中间隔着一整片无人能解释的黑箱。
在工程应用上,只要预测得准,这勉强可以接受。但在脑科学、物理学等极其严肃的科学探索中,这个缺陷太致命。
正如研究团队所指出的核心痛点:
神经网络预测得很好,但很难被理解。在以『解释』为终极目标的科学领域,这是一个严重的问题。
以神经科学为例,深度编码模型能够非常准确地预测大脑对自然刺激的反应,但它们却根本说不出,究竟是刺激中的「哪些特征」驱动了这些反应。
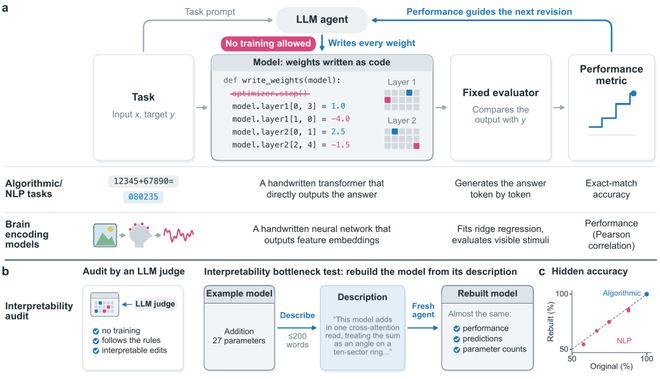
为了打破这个死局,微软团队提出了 iWSP。他们决定:不许用反向传播,直接让 AI 去设定那些旋钮。
在 iWSP 的框架中,Opus 5.5 化身为创世者。
它完全颠覆了传统的工作流:
纯粹的推理:面对任务,系统不允许 Opus 进行任何基于梯度的训练。每次迭代,智能体只能看到一个单一的验证分数(Validation score)。
手写权重:Opus 必须调用它已有的先验知识,构思一套计算逻辑。然后,它直接编写 Python 代码,显式地写出特征,将这套逻辑转化为具体的权重数字。
闭环迭代:Opus 评估这些特征,重复利用已知的正确模块,并根据那个单一的分数反馈,不断修改代码。
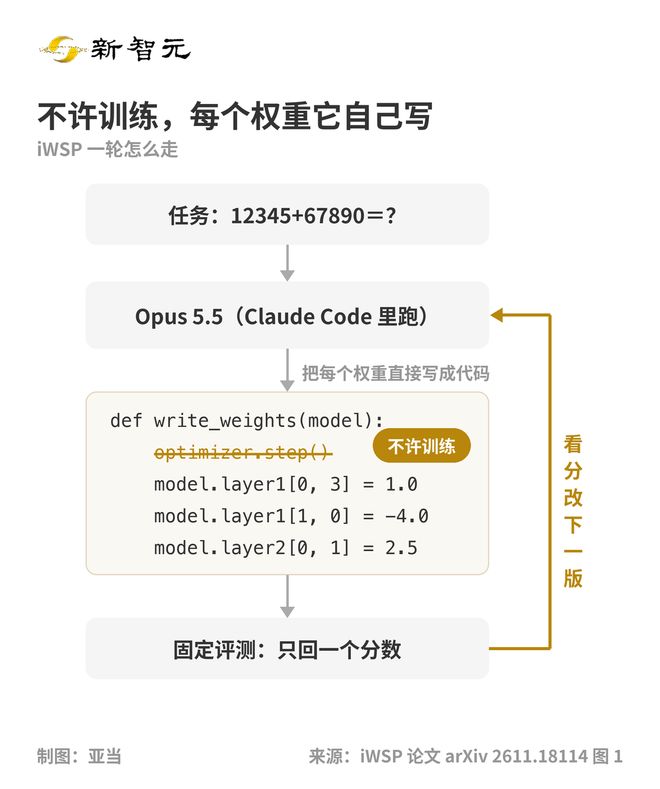
平均每次跑 39 轮左右。
最终诞生的,是一个人类可以像阅读普通书籍一样,从头读到尾的「透明」Transformer。
它的每一个部分、每一行权重,都是 AI「有意写就」。
反常识的真相
这项实验最让人拍案叫绝的,不仅是它成功让 AI 造出了 AI,更在于它揭示了一个违背直觉的真相。
在传统的 AI 语境里,我们笃信「大力出奇迹」。千亿参数只是起步,万亿参数才是未来。
大家都以为,神经网络越大越能干。
但这篇论文的数据,直接把这个常识反了过来。
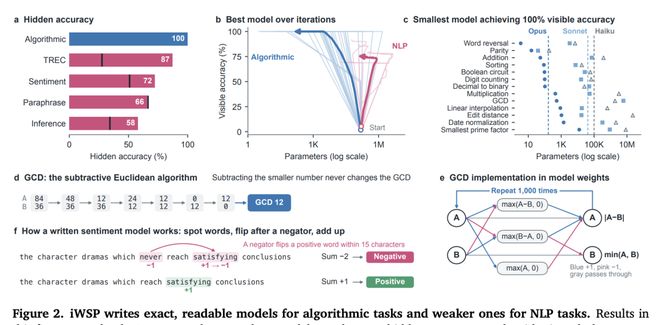
在 13 类算法实验中,所有由 AI「手搓」出来的模型,最终都在隐藏测试集上拿到了100% 的准确率。
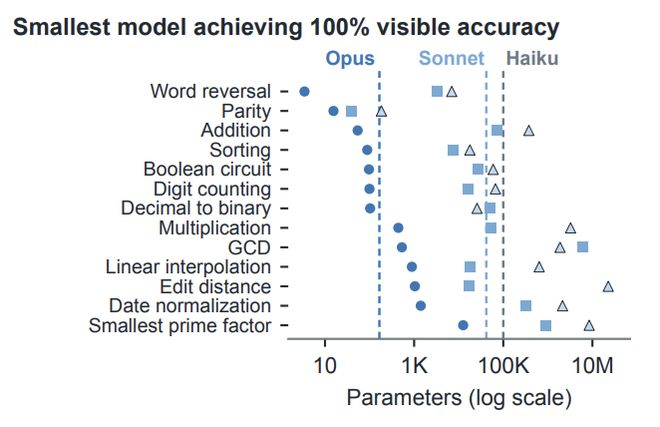
但当我们对比 Anthropic 家族不同级别的模型时,神奇的现象出现了:同样把算法题写到全对,越强的 AI,写出的网络越小。
相对基础的 Haiku 5.5手写的网络,参数量中位数高达100,000 个。
中等 Sonnet 5.5需要的参数量中位数是41,600 个。
当前最强的 Claude 模型 Opus 5.5,它手写的网络参数中位数,只有极其夸张的166 个!
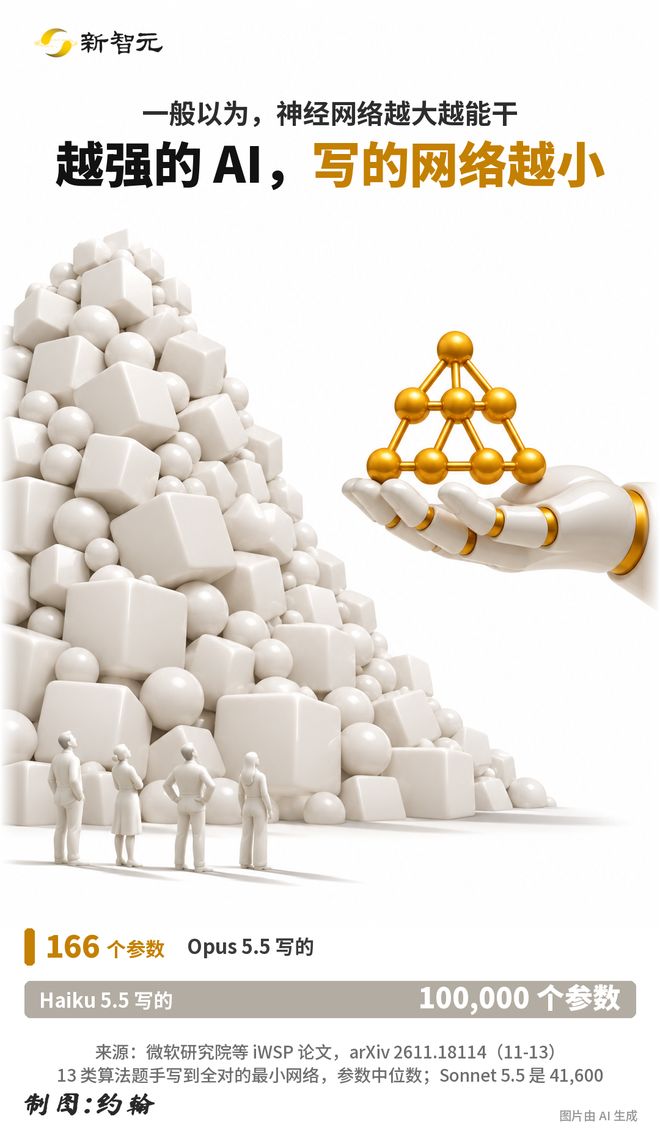
建议大家把「166 个参数」打在公屏上。在这个动辄千亿、万亿参数的大模型时代,166 个参数简直就像一颗微尘。
为什么会有这么离谱的差距?
日志记录了 Opus 的「心路历程」:Opus 的策略是,先想办法写对,再一轮一轮地往小里删。
一开始,Opus 为了保证逻辑能跑通,也会先写一个大概有 3400 个参数的网络。
在可见集拿到 100% 满分后,它开始疯狂精简代码。它把冗余的计算剔除,把复杂的矩阵压缩,硬生生把平均 3400 个参数,删到了 200 个上下。
这就像是学霸和学渣的区别。
学渣(Haiku)不懂公式背后的原理,遇到不会的题就靠死记硬背,把所有可能的情况都塞进脑子,所以需要 10 万个参数的「大笔记本」。
而学霸(Opus)彻底看透了算法的本质,直接提炼出了最核心的计算规则,所以只需要 166 个参数的「一张小纸条」。
这个发现极其震撼。它证明了:如果能找到真正正确的逻辑,解决复杂问题根本不需要堆砌。
从数学题到人类大脑,让科学免于「被糊弄」
你可能会问:费这么大劲,让 AI 手搓几个做数学题的极小模型,到底有什么用?
答案是:为了真正的科学发现。
科学界目前正面临一个尴尬的困境。拿神经科学来说,科学家为了搞懂人类大脑,会使用现成的深度学习黑盒模型来预测大脑的反应。
确实,模型预测得很准,但科学家傻眼了:我用一个搞不懂的黑盒,去预测另一个搞不懂的黑盒(大脑)。预测对了有什么用?我还是不知道大脑到底是怎么工作的!
我们需要的是「解释」,而不仅仅是「预测」。
微软团队这套 iWSP 方法的价值,在这里大发神威。
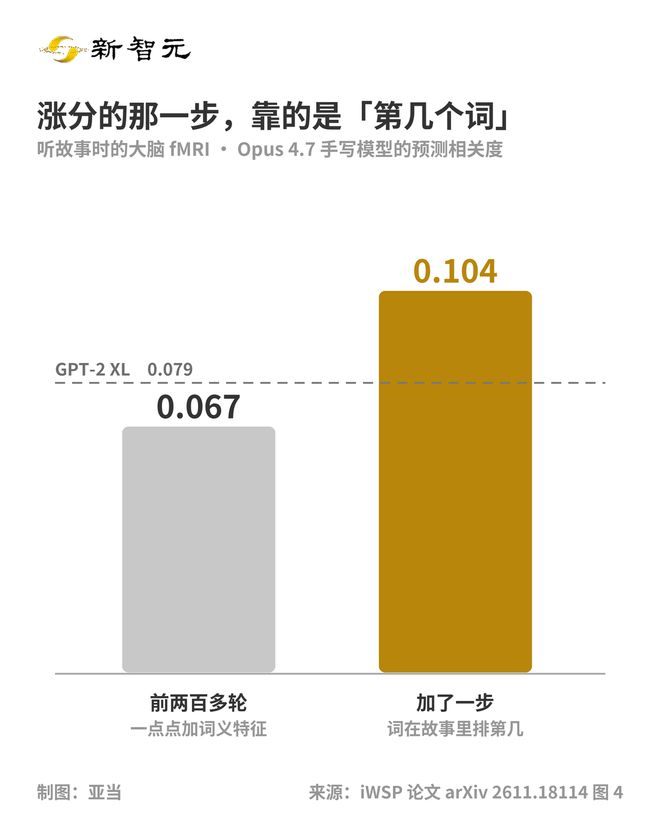
因为它造出的网络,内部逻辑是透明的。研究团队将这个方法,直接应用到了极高难度的大脑数据(Brain Encoding Models)中:在语言 fMRI(功能性磁共振成像)的实验里,iWSP 立下了大功。
面对复杂的大脑数据集,如果用传统的反向传播训练,黑盒模型会为了拿到高分,偷偷利用数据里的瑕疵来作弊。
科学家根本察觉不到。
但在 iWSP 中,Opus 4.7 把模型一步步明确地写了出来。在分析这个全透明模型时,科学家瞬间发现了不对劲:这个模型精准地揪出了数据集里的一个混杂漏洞!
它直接把问题摆在了明面上。
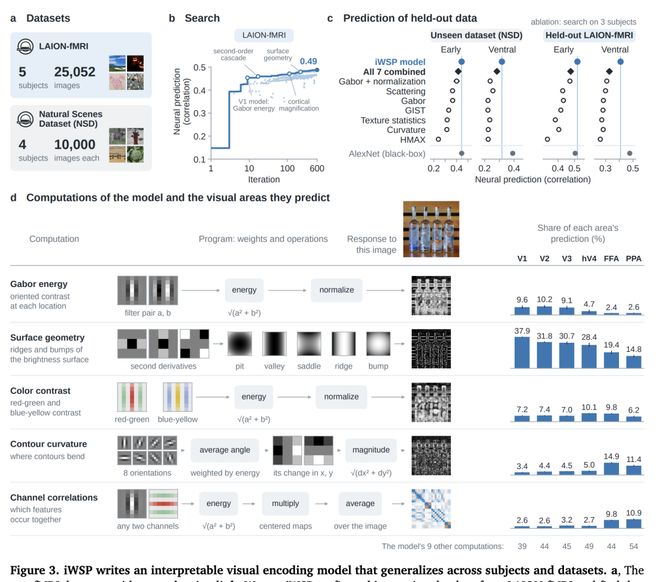
此外,在视觉皮层任务中,iWSP 不仅预测效果超过了现有的可解释模型,还清晰地展示了在早期视觉和高级视觉区域,大脑如何进行不同计算。
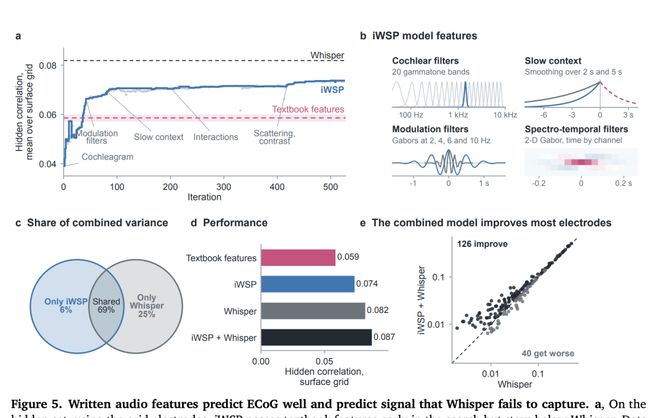
在听觉 ECoG(皮层脑电图)数据上,它系统性地发现并定义了那些能够预测神经活动的「可解释声学特征」。
通过 iWSP,AI 真正变成了帮助科学家发现真理的显微镜。
AI 自主进化的黎明时刻
读到这里,许多人可能会激动地大喊:深度学习的「炼丹时代」结束了!以后训练大模型再也不需要买几万张英伟达 H100 显卡了,直接让超级 AI 写权重就行了!
且慢。
尽管 iWSP 在纯算法任务和脑响应预测中非同凡响,但在自然语言处理(NLP)任务中,它却撞上了南墙。
在情感分类等 NLP 任务中,人类的语言特征高度模糊、非结构化,充满了幽默、反讽、多义词,根本没有绝对清晰的「数学公式」或「计算模块」可以套用。
面对这种任务,Opus 5.5 显得颇为吃力。
为了达到一定的准确率,它不得不拼命增加特征,导致模型参数量被迫膨胀到了 19 万个左右。更残酷的是,参数涨到 19 万,情感分类也只到 72%;四个语言任务里,复述判断那个连「全猜最常见答案」的基线都没过。
这指出了当前 iWSP 方法的核心局限性:它目前主要擅长「重组已知的算法和计算模块」。
复杂表征的涌现,目前依然离不开海量数据和梯度下降。
因此,绝对不能据此认定,通用大模型(AGI)已经不需要训练了。
真正底层的基座模型,依然需要算力的「暴力美学」。
尽管如此,微软的这项研究,依然是 AI 史上一个迷人的里程碑。
它向世界证明:在特定的场景下,神经网络可以摆脱「盲目进化」。
参考资料:
https://arxiv.org/abs/2611.18114
https://github.com/csinva/weight-space-programming-autoresearch
编辑:大卫
 科技
3000万招聘NPC、最高年薪千万,景区疯抢“打工人”
2026-10-08
 科技
QQ宠物登陆鸿蒙系统:会卖萌还会串门交朋友
2026-09-28
 科技
OpenAI开始断网训练最强模型:“安全起见”
2026-10-27