On-policy distillation(OPD)的做法很简单:先让学生自己生成回答,再由教师逐 token 提供反馈,指导学生更新。这样教师就能直接针对学生实际生成的内容进行指导,而不必依赖预先准备好的答案。问题在于,每一轮训练都需要学生生成完整的回答,之后教师还要对每个位置进行评估。随着回答变长,训练成本也会越来越大。
因此,我们提出了 STOPD:在生成前随机选好停止位置,然后让部分学生回答提前结束,最后再通过逆概率加权补偿截断带来的采样偏差。整个过程不需要评估回答质量,也不需要额外调用模型来判断何时停止。
在我们的实验中,STOPD 在准确率与 Vanilla OPD 相近的情况下,减少了 25%–48% 的生成 token,实现了 1. 3–2.2 倍训练加速。在理论上,我们还额外证明了加权后的梯度总和在期望上与完整生成一致,并给出了 SGD、Adam 和 Muon 下的单步更新误差界。
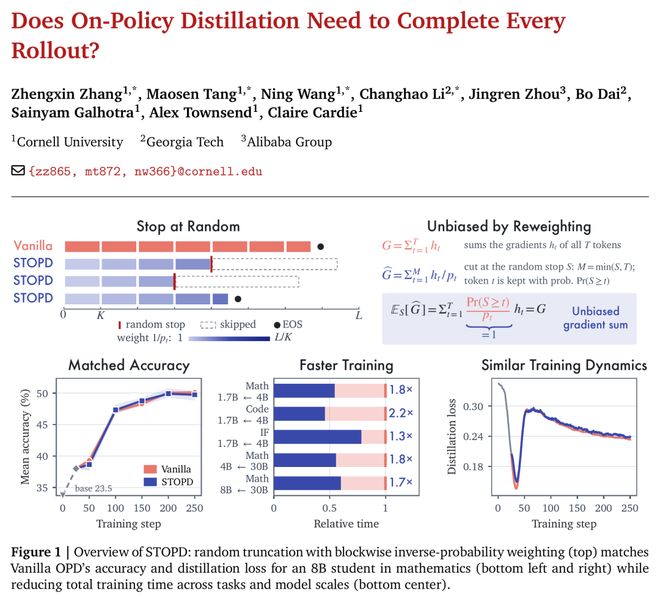
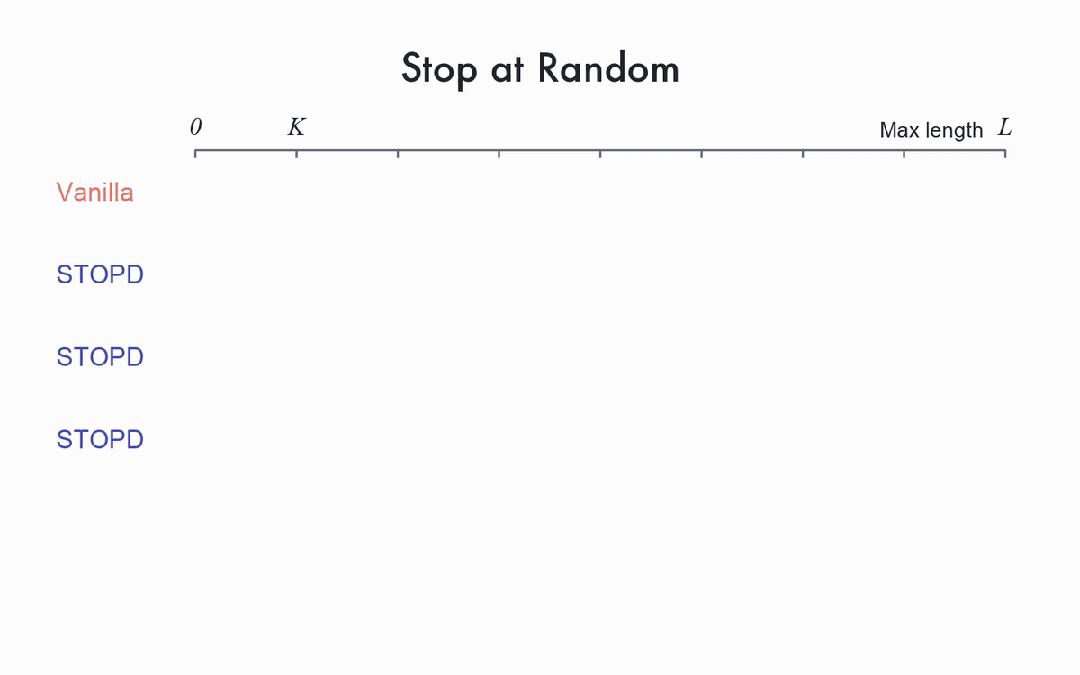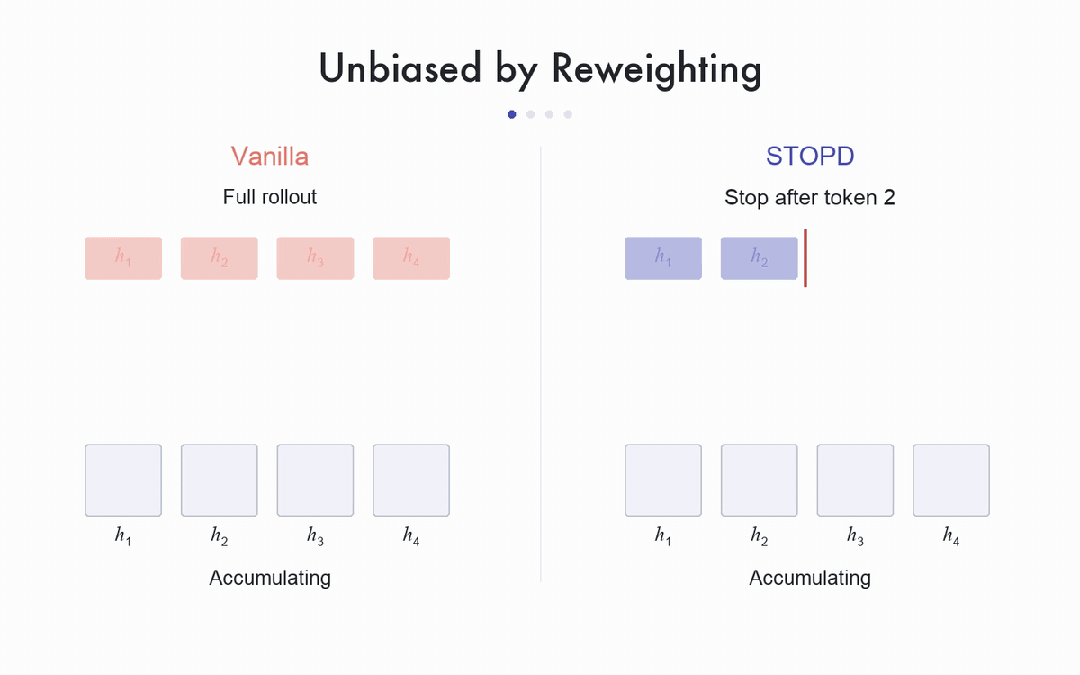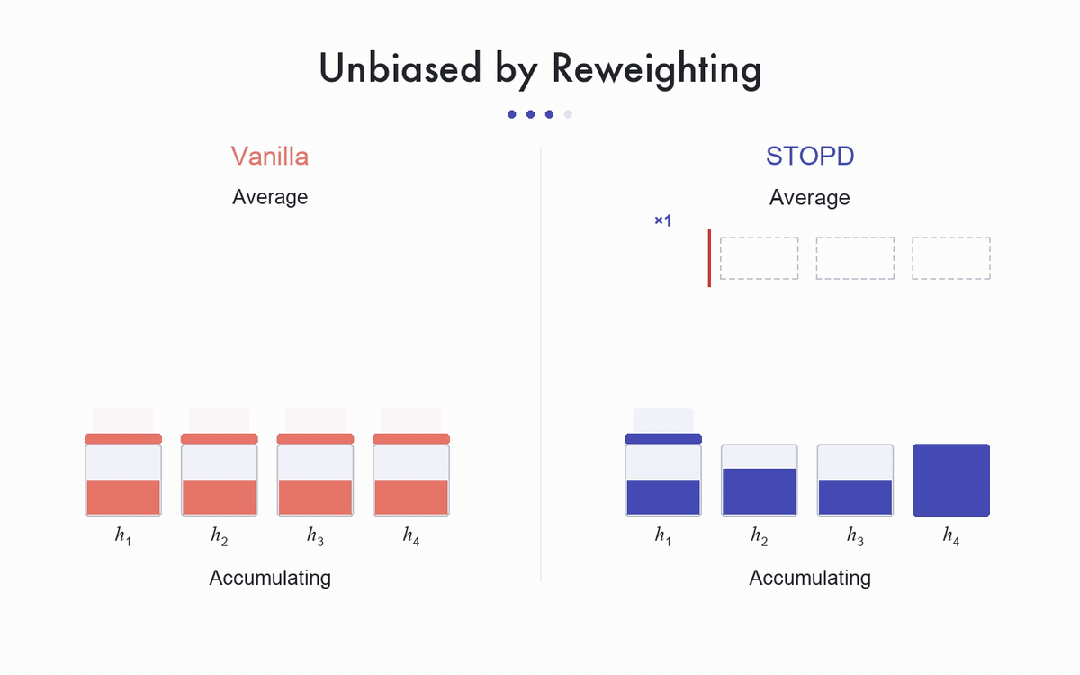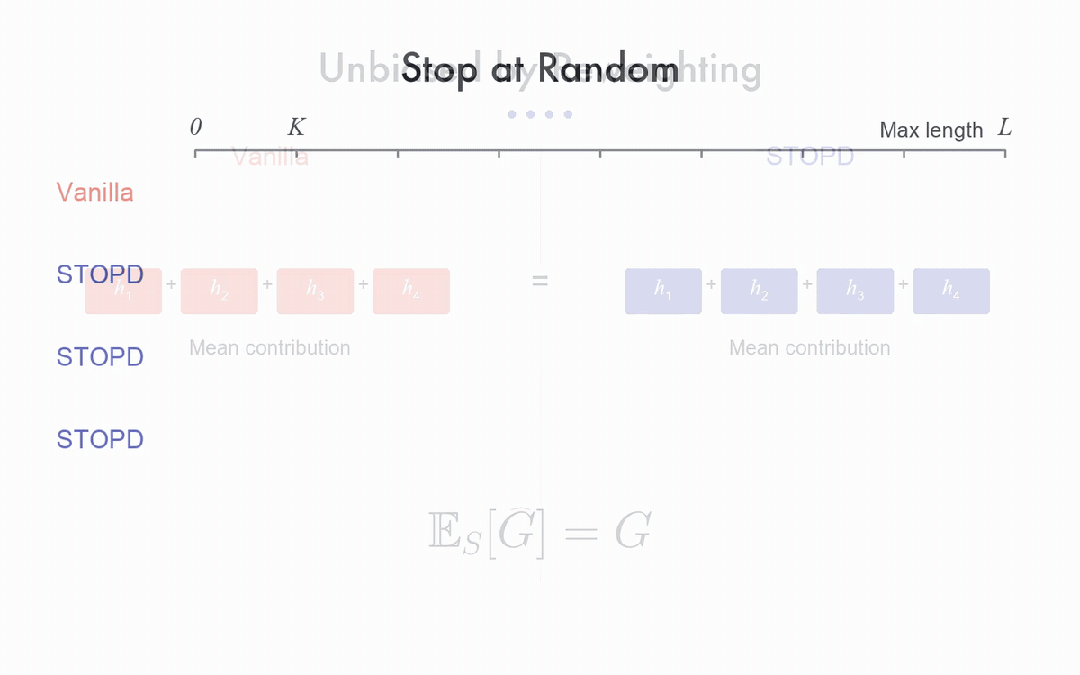
图 1|STOPD 的方法与实验结果。
已有方法如何减少计算
减少 OPD 开销通常有两种做法。
一种是稀疏监督:学生仍然生成完整的回答,但只选择部分 token 参与训练。这样的话如何选出值得监督的 token 就成了关键。有的方法关注学生在哪些位置更需要指导,比如 TIP [1] 根据学生的不确定性和师生分歧进行选择。有的方法关注教师的指导能否被学生有效吸收,比如 TA-OPD [2] 考虑教师信号的可学习性。还有的方法关注训练信号本身是否可靠,例如 IER [3] 考虑梯度估计的可靠性。这些方法虽然选择标准不同,但都通过减少了需要监督的 token 数量的方法削减了开销。
另一种是直接截断生成。最简单的做法是直接限制生成长度,比如 Early Stopping Rollout(ESR)[4] 只保留固定长度的前缀。在此基础上,Progressive OPD(POPD)[7] 进一步考虑训练进度,让生成长度随着训练逐步增加。除了预先设定长度规则,也有方法利用师生反馈动态调整生成过程。比如 Prune-OPD [5] 根据预测重叠度调整后缀权重和生成预算,而 KAT [6] 则在师生 KL 持续较低时提前停止生成。
截断虽然能直接省下生成计算却让被截掉的位置不再贡献梯度。如果不加以补偿,得到的期望梯度就不再与 Vanilla OPD 一致。而如何选择截断位置,同样是个问题。如果始终保留固定长度的前缀,回答后部就无法得到监督。如果根据师生反馈动态决定何时停止,又需要判断后续的监督是否还有保留的价值。
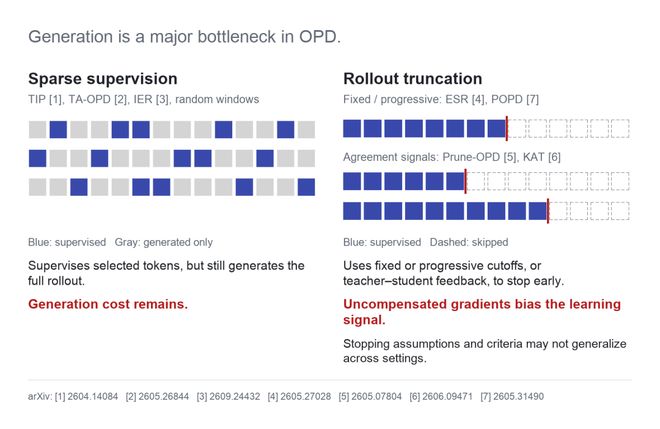
图 2|稀疏监督与截断生成的区别。
STOPD 怎么做
我们先考虑一种最简单的随机截断方式:在每条回答开始前,我们都会独立地均匀采样一个停止位置。生成过程会在到达该位置时停止,除非学生此前已经自然结束回答。对于被截断的部分,我们不再生成后续 token,也不再计算相应的教师反馈和训练损失。
不过,直接截断会带来两个问题。首先,这样做会让靠前的位置更常被保留,靠后的位置则更容易被遗漏。如果直接使用保留下来的损失,期望梯度就不再与完整生成一致。一个自然的解决办法是使用逆概率加权(IPW),将每个 token 的损失乘以其保留概率 p 的倒数,从而补偿截断带来的采样偏差。
但这又引出了第二个问题:尾部 token 的补偿权重可能变得非常大。以最大生成长度 16,384 为例,最后一个 token 被保留的概率只有 1/16,384,而一旦被保留,就会获得高达 16,384 的权重。
因此我们加入了分块截断:先把最大长度内的位置划分成等宽的连续块,抽中某个位置后,生成到它所在块的末尾再停。块内后部位置的保留概率随之提高,最大权重也降下来。例如,最大长度为 16,384、块宽为 128 时,最大权重从 16,384 降到 128。
将随机截断、逆概率加权和分块截断结合起来,就得到了我们的 STOPD。
动图|随机截断,以及各位置的加权贡献。
为什么梯度总和无偏
我们可以用一个简单的例子来说明。假设在一条完整回答中,某个 token 的梯度贡献为 g,而它有四分之一的概率在随机阶段后被保留。按照 STOPD 的加权方式,如果这个 token 被保留,它的贡献就会变成 4g,否则贡献为零。对随机停止位置取期望,我们就有
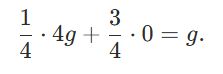
也就是说经过加权后,每个位置的期望梯度贡献都与完整生成时一致。将所有位置的贡献相加,就能恢复完整回答的期望梯度总和。
除此之外,我们还分析了实际训练中的损失归一化,以及 SGD、Adam 和 Muon 三种优化器如何将梯度转化为参数更新,并给出了相应的单步更新误差界。
主实验结果
我们用 Qwen3-4B-Instruct-2507 作为教师、Qwen3-1.7B-Base 作为学生,在数学、代码和指令遵循上比较 STOPD 与 Vanilla OPD。
两种方法在训练过程中呈现出相似的蒸馏损失变化趋势,在第 250 步的评最终测结果也十分接近。具体来说,Vanilla OPD 与 STOPD 在数学任务上的平均准确率分别为 30.1% 和 29.4%,代码任务上的平均通过率分别为 28.5% 和 28.1%,指令遵循任务上的准确率则分别为 59.8% 和 60.1%。
对应的计算节省是:
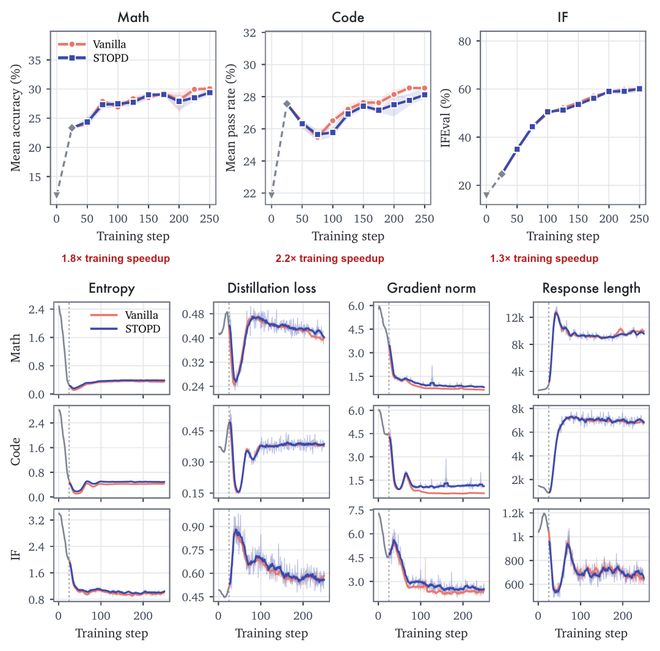
图 3|三个领域的准确率、训练加速与训练动态。
更大的模型
我们进一步将教师模型换成 Qwen3-30B-A3B-Instruct-2507,并将学生模型扩大到 4B 和 8B。在这两个规模上 STOPD 的准确率仍与 Vanilla OPD 接近,损失曲线也保持着相似的变化趋势。与此同时,生成 token 分别减少了 35%33%,训练速度则提升至 1. 8 倍 1. 7 倍
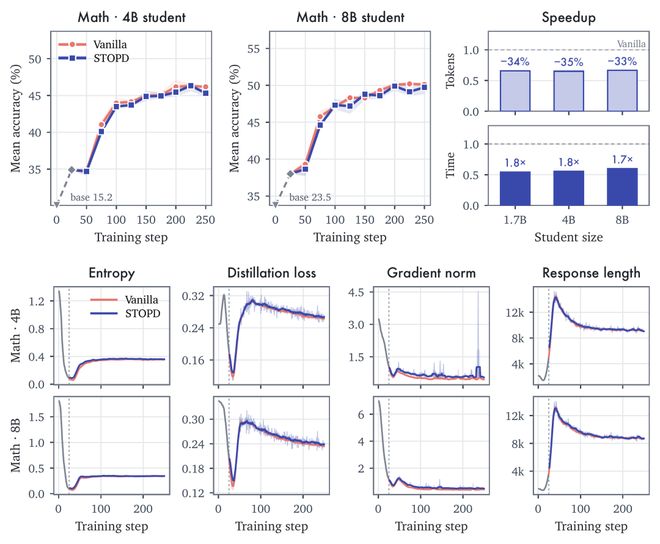
图 4|4B 和 8B 学生模型上的结果。
换用 SGD 和 Muon
除了模型规模,我们还考察了 STOPD 在不同优化器下的表现。在数学任务上,将 AdamW 换成 SGD 和 Muon 后,STOPD 依然实现了 2. 2 倍 1. 9 倍的训练加速,准确率也与 Vanilla OPD 保持接近。具体来说,使用 SGD 时,两者的最终准确率分别为 25.2% 和 25.1%。使用 Muon 时则分别为 29.5% 和 29.8%。
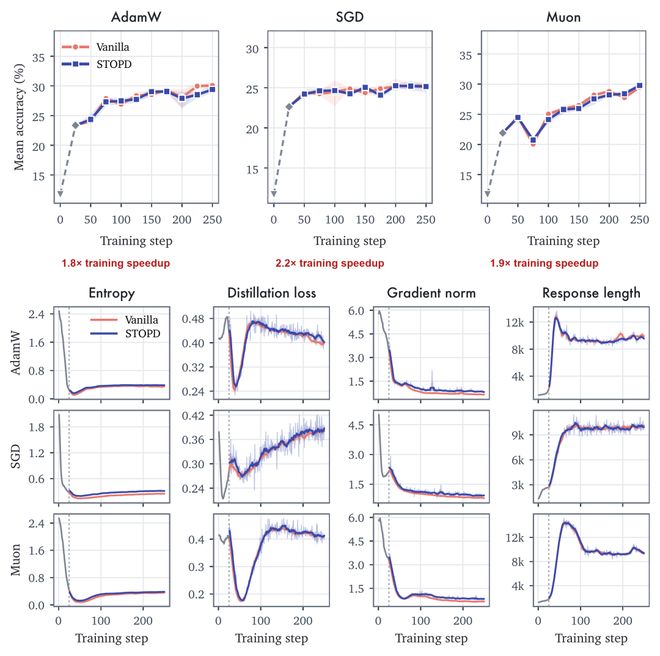
图 5|AdamW、SGD 和 Muon 下的准确率与训练动态。
Batch size 和块宽怎么选
随机截断会给训练带来额外的损失波动,而增大 batch size 可以缓解这一问题。由于每条回答的停止位置都是独立采样的,同一个 batch 中包含的回答越多,随机波动就越容易相互抵消。
可以看到,当我们在数学任务上将 batch size 从 128 增加到 512 后,STOPD 的 loss jitter 从 12. 2% 降至 6.0%,同时依然保持 2.0–2.1 倍的训练加速。Loss jitter 衡量相邻训练步之间的损失波动,而当 batch size 增加四倍时这一波动也几乎减半,恰好符合随机误差随 batch size 的平方根倒数减小的理论预期。
除了 batch size,我们还考察了块宽的影响。更大的块宽可以降低最大补偿权重,但也需要生成更多 token。我们测试了 32 到 2048 的不同块宽,发现准确率整体接近,因此默认使用 128。
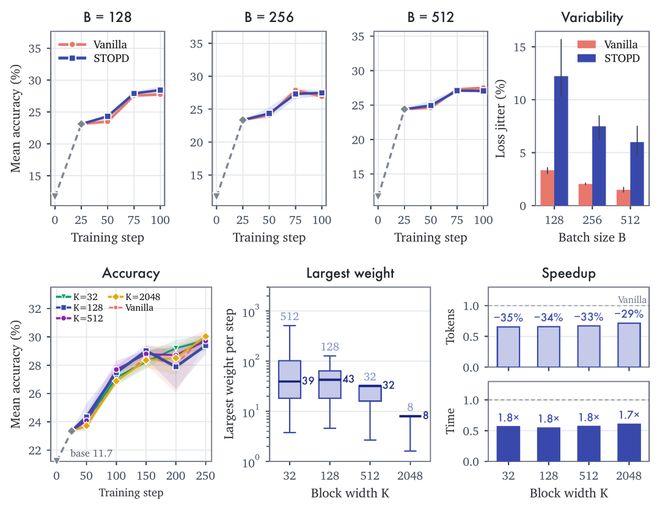
图 6|Batch size 与块宽的影响。
和固定截断 ESR 比较
我们还在数学任务上比较了 STOPD 与固定截断方法 ESR [4]。ESR 的评测准确率较早进入平台期,但评测时生成的回答却持续变长,触及长度上限的比例也不断增加。相比之下,STOPD 在准确率和回答的停止行为上都更接近 Vanilla OPD。
这一差异与两种方法处理后部 token 的方式有关。ESR 在固定位置截断生成,使后续 token 始终无法得到教师监督。如果自然结束符位于截断点之后,学生也就失去了学习何时结束回答的机会。而 STOPD 让每个位置都有机会参与训练,包括靠后的自然结束符,并通过 IPW 补偿它们较低的保留概率。
这也是我们重视无偏梯度估计的原因:我们希望减少生成成本的同时,仍然保留每个位置原有的期望梯度贡献。
图 7|ESR、Vanilla 和 STOPD 的准确率、评测回答长度及触及长度上限的比例。
OPD 不必每次都生成到最后
OPD 的关键是让学生从自己生成的回答中获得有效的监督,而不是每次都必须生成完整回答。STOPD 说明,只要合理选择截断位置,并对采样偏差进行补偿,就能在减少生成计算的同时保留完整回答原有的期望梯度贡献。换句话说,OPD 不必每次都生成到最后。
目前,论文和代码均已公开。除了 OPD,这一思路也有望应用于其他使用逐 token 监督的训练方法,例如在线与离线知识蒸馏、监督微调等。我们也希望进一步探索随机截断与加权补偿在这些场景中的效果。
作者介绍
Zhengxin Zhang、Maosen Tang 和 Ning Wang 为康奈尔大学博士生,Changhao Li 为佐治亚理工学院博士生。四位共同一作的研究涵盖大模型推理与高效训练、神经网络理论、数据管理及智能体学习。
参考文献
[1] TIP: Token Importance in On-Policy Distillation. https://arxiv.org/abs/2604.14084
[2] Not All Disagreement Is Learnable: Token Teachability in On-Policy Distillation. https://arxiv.org/abs/2605.26844
[3] 1% of Tokens Can Be Enough: On Gradient Estimation in On-Policy Distillation. https://arxiv.org/abs/2609.24432
[4] Less is More: Early Stopping Rollout for On-Policy Distillation. https://arxiv.org/abs/2605.27028
[5] Prune-OPD: Efficient and Reliable On-Policy Distillation for Long-Horizon Reasoning. https://arxiv.org/abs/2605.07804
[6] Escaping the KL Agreement Trap in On-Policy Distillation. https://arxiv.org/abs/2606.09471
[7] Are Full Rollouts Necessary for On-Policy Distillation? https://arxiv.org/abs/2605.31490
 科技
3000万招聘NPC、最高年薪千万,景区疯抢“打工人”
2026-10-08
 科技
QQ宠物登陆鸿蒙系统:会卖萌还会串门交朋友
2026-09-28
 科技
OpenAI开始断网训练最强模型:“安全起见”
2026-10-27