新智元报道
如今 Agent 已经能熟练调用工具、修改文件、运行测试,但面对一个长期演进的大型软件系统,它能否从一份新需求出发,交付完整功能?
产品经理提出新需求,开发者拿到的往往不是文件清单或函数签名。需要先理解约束,追踪模块依赖,再判断改哪里、怎么改、怎样证明改对了。这些分析影响后续交付。
复旦大学、香港城市大学、香港中文大学等机构提出 LoLBench,把 Agent 放进平均约 240 万行源代码的软件系统,评估从功能提案到模块交付的完整过程,检验把需求落到系统中的感知能力,以及完成跨模块修改的实现能力。
论文链接:https://arxiv.org/abs/2609.37143
数据集:https://huggingface.co/datasets/lolbench26/LoLBench
实验暴露出关键断点:Agent 可能改对局部,却漏掉其他模块中必须同步的改动。即使补充实现指引,多数任务仍未解决,从理解需求到完成交付仍有很长距离。
重新定义长程代码任务
什么样的长程代码任务,才有实际工程价值?
「长程」不能只看耗时、轮数或 Token 消耗。例如让 Agent 每分钟输出一个数字,从 1 数到 1000,虽然耗时很久,却只需简单循环。SWE-bench 类局部 Bug 修复的任务,也不能覆盖从需求分析到模块交付的挑战。
LoLBench 关注的长程代码任务,是面向复杂系统的模块开发。接到新需求后,开发者会反复分析:哪些行为必须实现?已有架构能否支持?哪些依赖会受影响?怎样验证?LoLBench 把这部分藏在开发者脑子里的分析也纳入评估,让 Agent 自行完成从用户意图到实现方案的推导。
这类任务同时具有感知复杂性和实现复杂性:前者是读懂提案、识别隐含约束和跨模块依赖、推导修改范围与实现规范(specification)的难度;后者是将规范转成正确的跨文件修改,并通过测试和修复避免已有功能被破坏的难度。
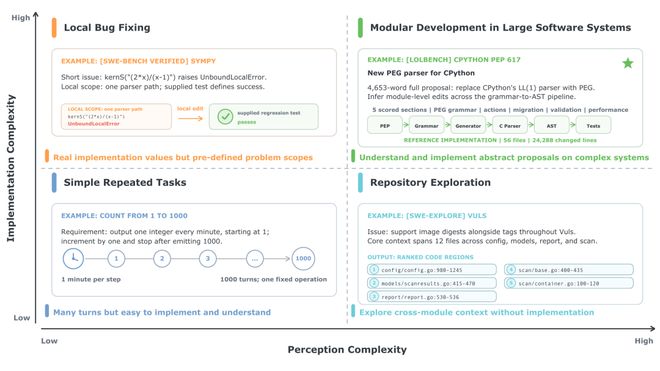
图 1 感知复杂性与实现复杂性的比较。
LoLBench 如何同时评估两类复杂性
从功能提案推导实现规范
LoLBench 从社区功能提案(Enhancement Proposal)及对应的已合并 PR 中选取 100 项任务,覆盖 29 个系统、8 种语言和 5 个领域。
Agent 仅获提案与实现前代码仓,提案平均约 5000 个英文单词。评测在断网的 Docker 环境中开展,防止 Agent 检索上游实现。
例如,PEP 617[1]提议用 PEG 替换 CPython 的 LL (1) 解析器,实现时需贯通语法定义、解析器生成、抽象语法树与错误报告。Agent 必须识别整条实现链路。
感知复杂性方面,LoLBench 参考实现的目标类名在提案中的平均提及率仅 7.3%,不到 SWE-bench Verified(15.9%)的一半,也不到 FeatureBench(38.7%)的五分之一。Agent 须自行推测需求与代码的联系。
把规范落实为工程交付
实现复杂性方面,LoLBench 仓库平均约 240 万行源代码,约为 SWE-bench Verified 的 9.4 倍、FeatureBench 的 4.9 倍;实现平均改动 5499 行,后两者分别为 38 行和 2050 行。每项任务平均改动 64.9 个文件、40.1 个类和 195.9 个函数;文件数分别为两者的 25 倍和 4.2 倍。跨模块协同与验证更难。
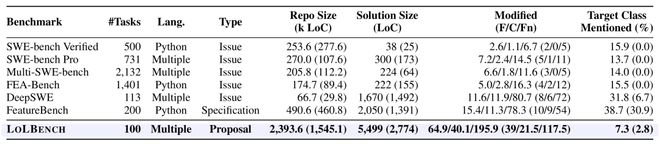
表 1 LoLBench 与现有代码任务评测集的对比。
LoLBench 通过两类测试验证交付正确性:新增功能测试(F2P)要求实现前失败、实现后通过,F2P 通过公开接口检验行为,允许不同内部实现。回归测试(P2P)要求前后均通过。
在项目原有的测试基础上,研究团队构造遗漏功能、篡改需求等错误实现作为变异体,补充测试用例识别漏检错误,并提高参考补丁的测试覆盖率。
增强后,1688 个变异体的检出率从约 61% 升至 96%,F2P 按任务平均的行覆盖率从约 60% 升至 79%。
28 种 Agent 组合的表现与瓶颈
换模型或脚手架,Agent 最高解决率仅 14%
研究团队评估 6 个前沿模型与 5 个脚手架的 28 个可用组合,单任务限时 6 小时。Opus 5 搭配 Claude Code 或 mini-SWE-agent 均以 14% 的解决率并列最高,全部组合的中位数仅2%。
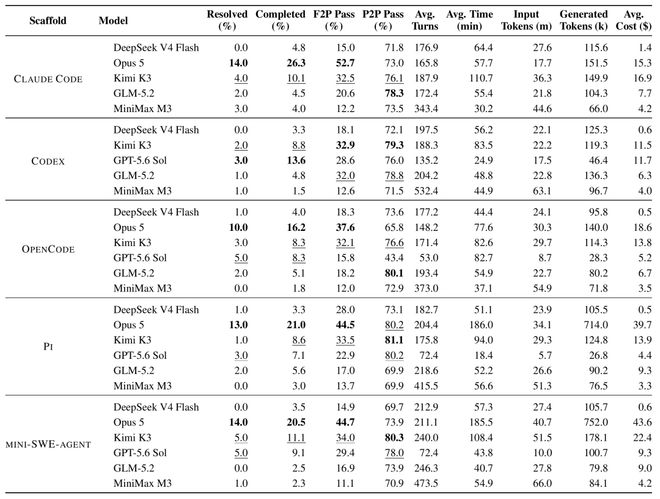
表 2 论文中的主要实验结果
同用 Opus 5,mini-SWE-agent 与 Claude Code 解决率相同,前者耗时为后者的 3.2 倍、生成 Token 为 5 倍,更多消耗未换来更高解决率。
大量交互与 Token 花在代码定位上
从 Token 消耗来看,按 Agent 平均,定位阶段占非缓存输入 Token 的 52. 4%、生成 Token 的 45. 4%。从 Agent 交互轮数来看,定位阶段的交互轮数也显著多于其他阶段。
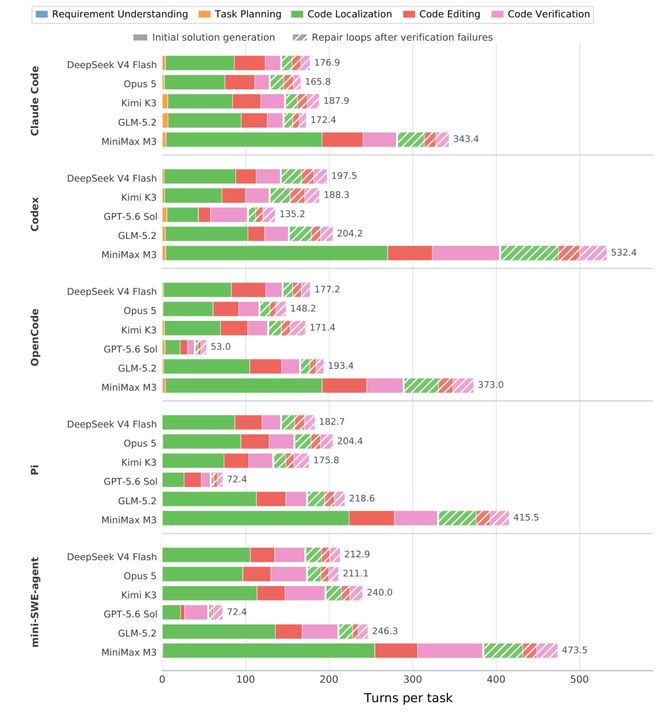
图 2 各阶段的平均交互轮数。
对照参考实现修改的既有文件和函数,全部 28 组 Agent 的文件修改精确率为 38.0% 至 80.4%,召回率为 30.3% 至 65.0%;函数修改精确率为 54.2% 至 65.6%,召回率为 20.8% 至 53.4%。代码定位准确率低,覆盖仍不完整。
补充修改指引后,Agent 仍难以完整交付
研究团队保留原功能提案,额外提供参考实现导出的修改文件树与 API 实现规范,帮助 Agent 确定修改范围。Opus 5+Claude Code 的解决率从 14% 升至 34%,GPT-5.6 Sol+Codex 从3% 升至 25%,DeepSeek V4 Flash+OpenCode 从1% 升至 17%。
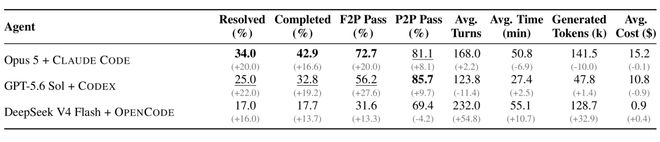
表 3 补充修改文件树与 API 实现规范后的实验结果
补充修改指引能缓解感知负担,但最佳组合仍有 66% 的任务未解决。Agent 仍需协调模块、实现接口并通过验证,这提示大型系统的实现复杂性同样很高。
从代码生成走向大型软件系统演进
这些结果为 Agent 研发提供了可检验的方向:仓库检索能否覆盖关键依赖,编码前的实现规范是否完整,验证能否及时发现跨模块遗漏。
软件工程的价值,在于用户需求能否被可靠兑现。Agent 需要理解变更为何发生、如何影响系统,并把变化完整实现。LoLBench 希望推动 Agent 能力评估从生成代码走向支持软件持续演进,让交付结果成为检验 Agent 能力的尺度。
参考资料:
PEP 617:https://peps.python.org/pep-0617/
编辑:LRST
 科技
3000万招聘NPC、最高年薪千万,景区疯抢“打工人”
2026-10-08
 科技
QQ宠物登陆鸿蒙系统:会卖萌还会串门交朋友
2026-09-28
 科技
OpenAI开始断网训练最强模型:“安全起见”
2026-10-27