新智元报道
这一天还是来了!
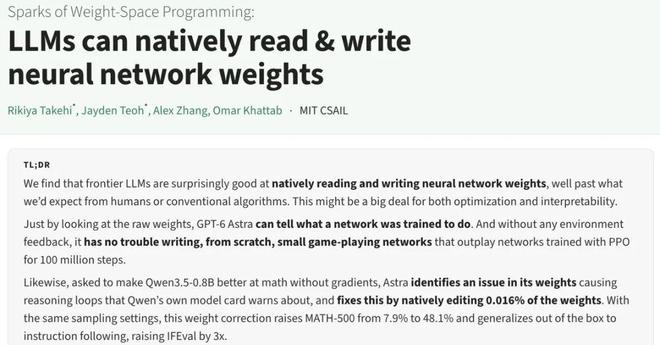
不用训练、不算梯度,只让 GPT-6 Astra 改写另一款小模型 0.016% 权重,数学成绩就能原地暴涨 6 倍!
今天,MIT 计算机科学与人工智能实验室(CSAIL)带来的这项新研究,在全网彻底火了。
他们首次提出了一个颠覆传统深度学习的新范式,「权重空间编程」。
要知道,神经网络的权重文件里全是一眼望不到头的数字。
过去四十年里,没有任何人类能肉眼看懂这堆数字在算什么,想改模型行为只能喂数据、算梯度,靠训练一步步微调。
但这一次,GPT-6 Astra 直接跳过了训练,光靠推理就能看懂并亲手改写底层权重。
靠着这手绝活,它不仅徒手治好了开源小模型 Qwen3.5-0.8B 的死循环毛病,甚至还能从零手搓出一个百万参数的围棋 AI!
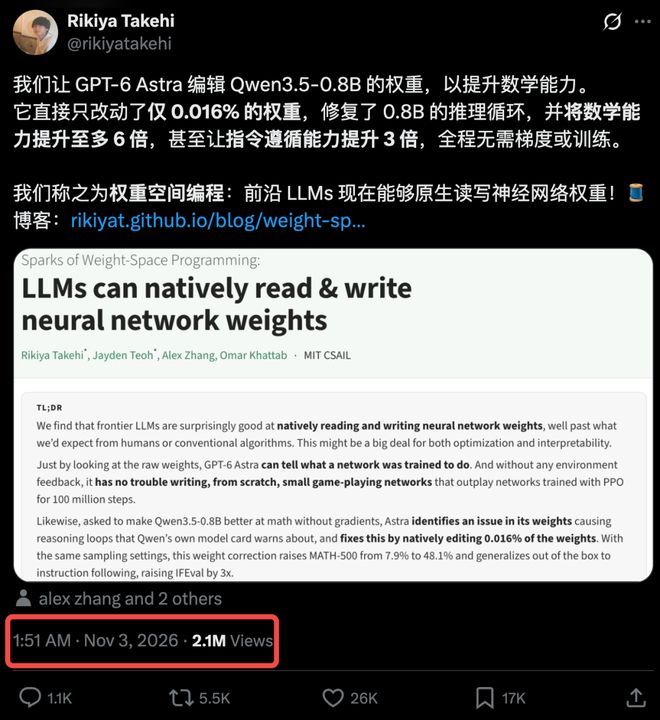
论文一经发布,全网破 200 万人围观,转发、讨论直接破圈,许多人在评论区直呼「见证历史」。
在硬核拆解「权重空间编程」之前,先划出这次 MIT 报告中的颠覆性重点:
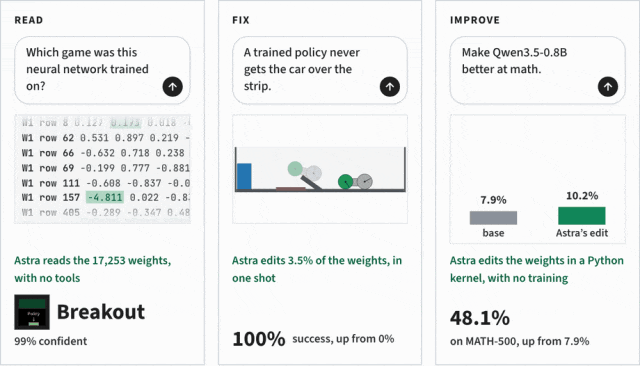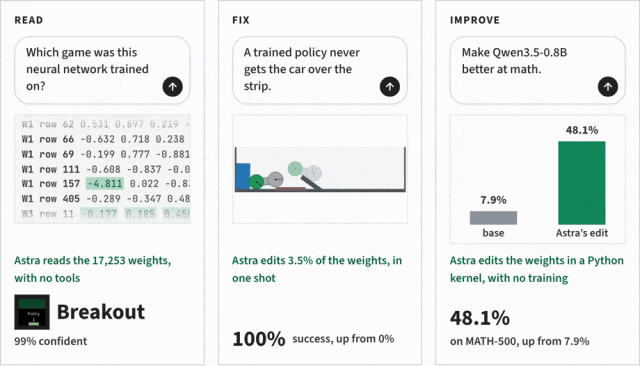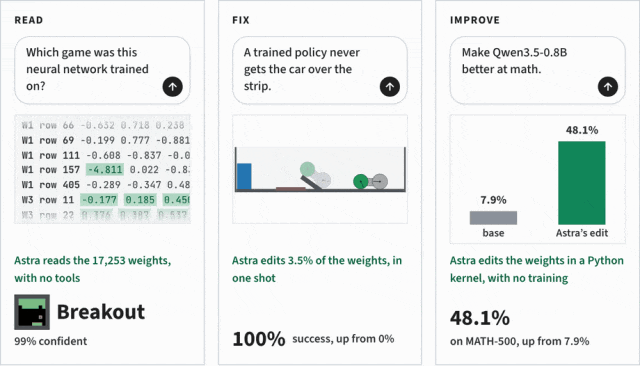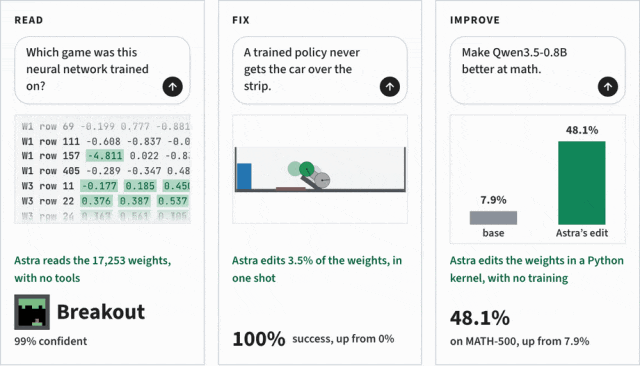
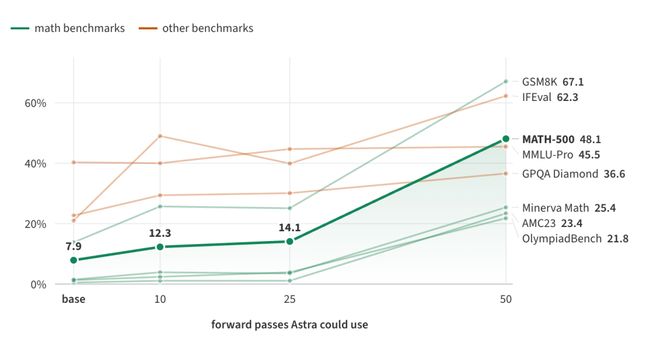
爆改权重:只改 0. 016% 的权重,Qwen3.5-0.8B 的 MATH-500 从 7.9% 飙到 48.1%,暴涨 6 倍,指令遵循翻 3 倍。
读懂神经网络:只看 17253 个数字,Astra 便以 99% 的置信度一眼认出,四个游戏策略网络各自在玩哪款游戏——打砖块、乒乓球、吃豆人和过马路。
徒手敲出权重:从全零开始,一次回复手写出打砖块网络,得分 517.4,是 PPO 苦练 5 亿步的 20 倍!
这篇由 MIT 博一 Rikiya Takehi 和团队交出的论文,彻底改变了所有人的世界观。
一夜之间,LLMs 能够原生读写神经网络权重了。
只改 0.016% 参数
像脑外科医生一样切掉「死循环」
最让人头皮发麻的,就是 GPT-6 Astra 给 8 亿参数的 Qwen3.5-0.8B 做的那场「微创脑手术」。
研究人员把共 24 层的 Qwen3.5-0.8B 放进一个只有 CPU 的沙盒里,让 Astra 在不跑训练的前提下提升它的数学成绩。
整个过程中,Astra 最多只能在练习题上试跑 50 次,用来观察小模型做题时的内部状态。
接手任务后,Astra 没有急着乱改数字,而是先拿 96 道数学题给小模型做了一次全面体检。
体检结果一下子暴露了病根。原版模型有 85 道题一头扎进了死循环,同一句车轱辘话来回念叨,直到把 3.2 万词元的长度上限耗光也没算出答案。
也就是说,这款小模型之所以在 MATH-500 上只考出 7.9% 的惨淡分数,是因为 93% 的题目都被「复读机死循环」硬生生拖死了。
既然找到了病症,下一步就是顺藤摸瓜,看看这个让人复读的开关到底藏在 24 层网络的哪个角落。
Astra 对比了正常做题和陷入死循环时的内部信号,很快抓到了异常,只要模型开始车轱辘话复读,第 15 层和第 19 层就会顺着一个固定的方向猛发信号。
为了验证这个猜想,Astra 先关掉了第 19 层里信号最强的第 11 号神经元试水,结果数学准确率立马来了一波 6 个百分点的上涨。
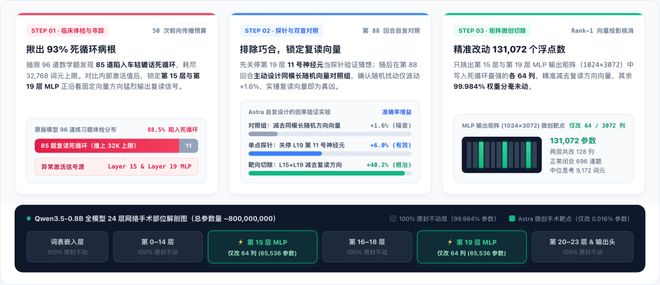
不仅如此,为了确认不是碰巧蒙对,Astra 还主动给自己加了一组对照实验,在权重里减去一个同样大小的随机方向。
看到随机对照组只带来 1.6 个百分点的微弱波动后,Astra 这才完全笃定,自己抓到的那个信号方向就是引发死循环的真凶!
锁定靶心后,它下刀稳准狠,只挑出第 15 层和第 19 层里写死循环最猛的各 64 列权重,精准抹掉这个复读信号。
算下来,全模型 8 亿参数里只改了 131,072 个数字(占 0.016%),其余 99.984% 的权重分毫未动!
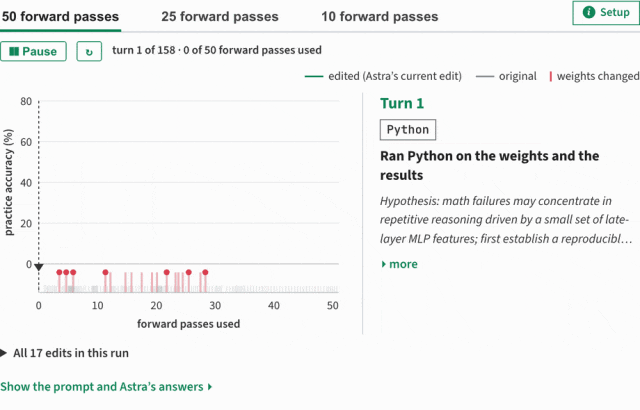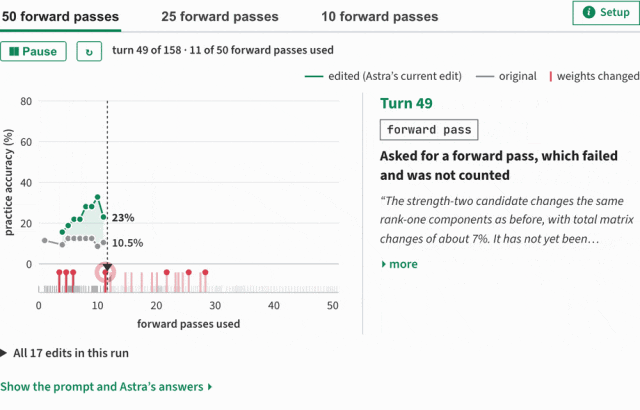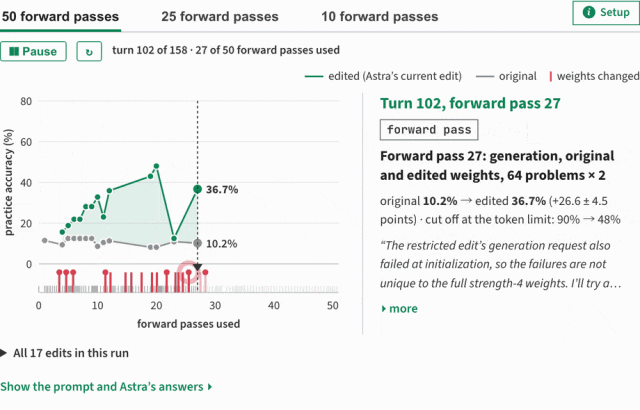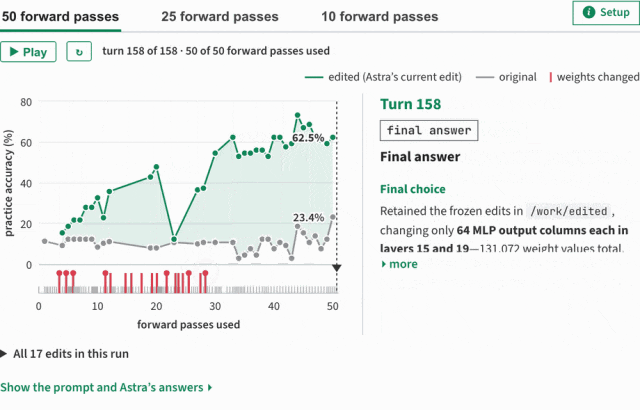
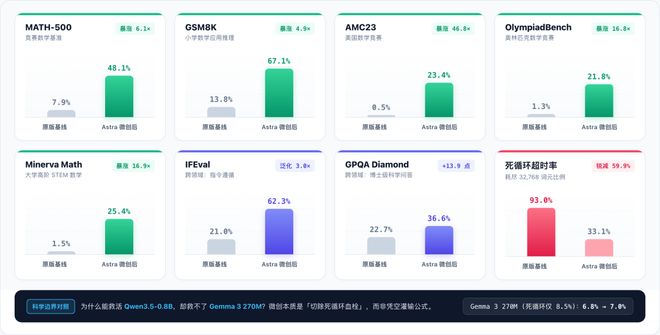
这记微创手术立竿见影,小模型做题卡进死循环的比例从 93.0% 暴跌到 33.1%,原本卡死的 696 道题全部顺利算出了最终答案。
当研究人员把改完权重的模型拉到 8 个 Astra 从未见过的权威测试集上检验时,被死循环封印的实力彻底爆发了!
MATH-500 准确率从 7.9% 飙到 48.1%,GSM8K 从 13.8% 冲上 67.1%,高难度的美国数学竞赛 AMC23 更是从 0.5% 暴涨到 23.4%,足足翻了 46.8 倍!
而且因为死循环原本也拖累着其他任务,切掉病灶后,模型在跨领域的 IFEval 指令遵循测试中也从 21.0% 跃升至 62.3%,连涨 3 倍。
看到这里可能有人会好奇,只改万分之一点六的权重就能暴涨 6 倍,难道大模型能凭空给小模型灌输数学知识。
MIT 团队紧接着用 2.7 亿参数的 Gemma 3 270M 做了一组反面实验,刚好回答了这个问题。
当 Astra 对 Gemma 3 270M 照方抓药后,它的 MATH-500 得分只从 6.8% 微动到 7.0%,连 Astra 自己都在报告里坦白没能改出效果。
原因很简单,Gemma 3 270M 平时很少卡进死循环(仅 8.5% 超时),它做不出题纯粹是因为公式没学会、算术算不对。
把这两个实验放在一起对比就能明白,现阶段的微创权重手术,本质上是帮模型「切掉阻碍实力发挥的脑血栓」,还不能在不训练的情况下凭空往它脑子里塞新知识。
即便如此,这种精准定位并切除病灶的操作依然让硅谷沸腾。
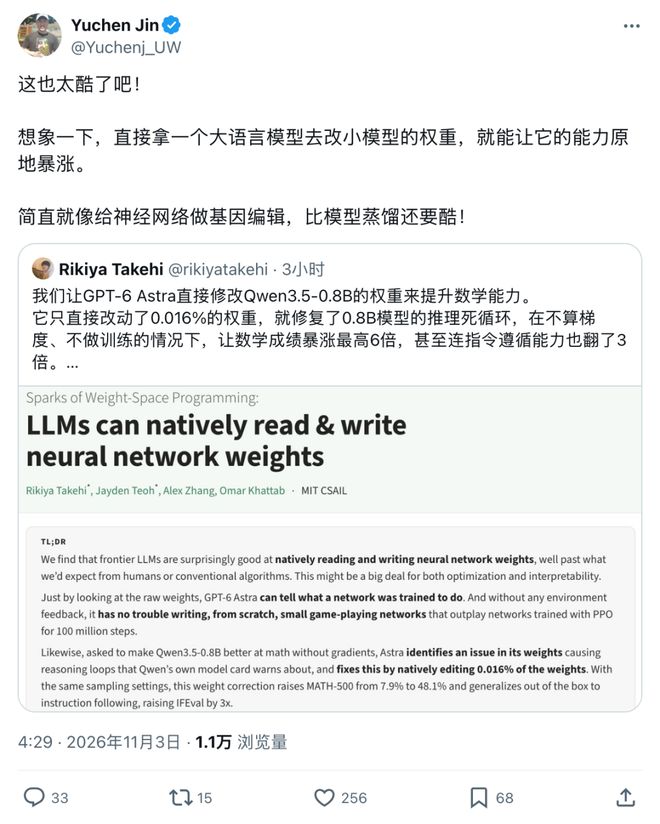
Hyperbolic 联合创始人兼 CTO 金雨晨直呼,用大模型改小模型权重就能让能力暴涨,简直就像给神经网络做基因编辑,比模型蒸馏还要酷!
把浮点数当源码读
看穿黑盒里的暗门
外科医生敢下刀的前提是看得懂X光片。Astra 之所以能精准切掉那 64 列权重,底气在于它已经能把密密麻麻的权重数字当代码读了。
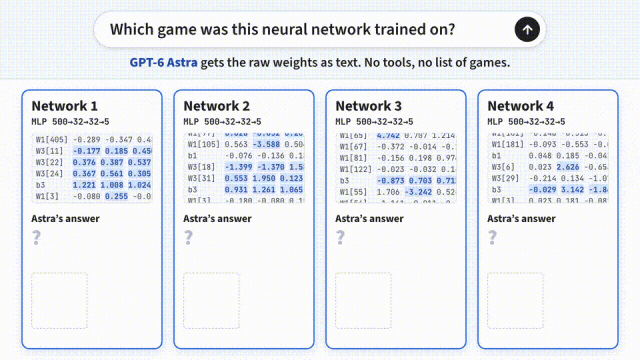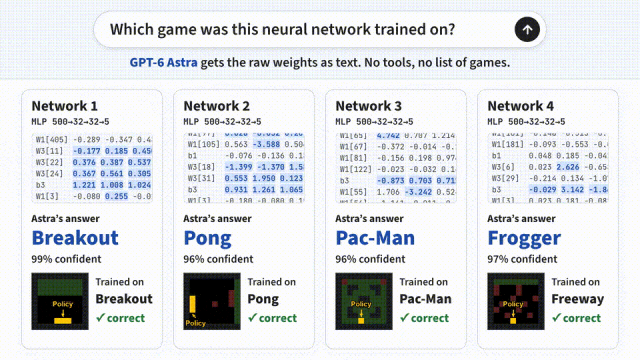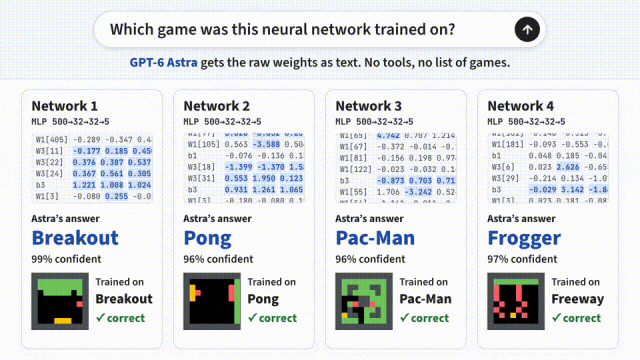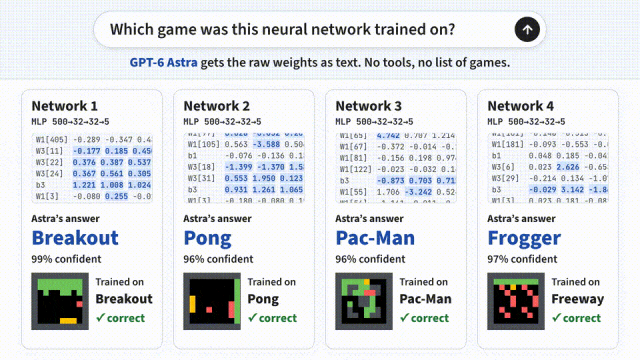
为了测试这种「盲读权重」的功力到底有多深,MIT 团队撤掉了所有运行工具,逼着 Astra 光靠肉眼看数字,去猜一个黑盒网络在玩什么游戏。
在第一关里,研究人员训练了 4 个结构一模一样(都是 1.7 万个权重)的小网络,分别去玩打砖块、乒乓球、吃豆人和过马路。
随后他们把这 1.7 万个数字转成纯文本塞进提示词,既不让跑代码,也不告诉它有哪些备选游戏,结果 Astra 居然 4 猜 4 中!
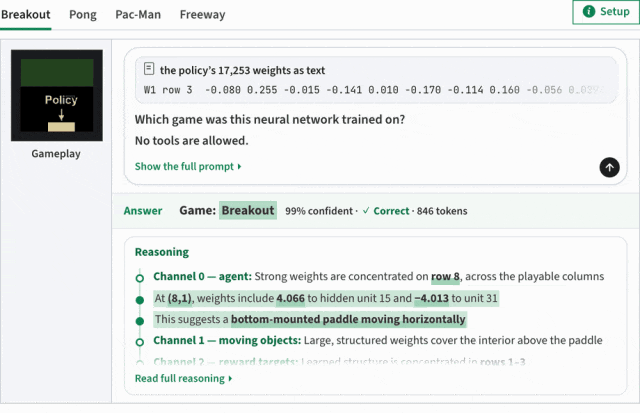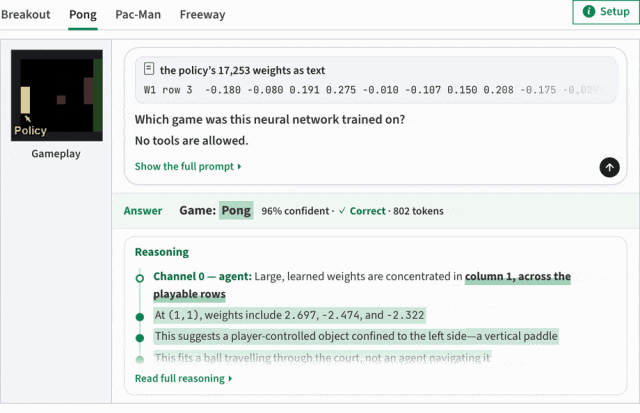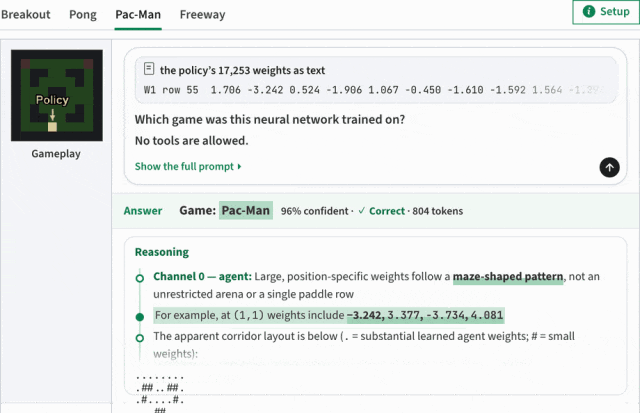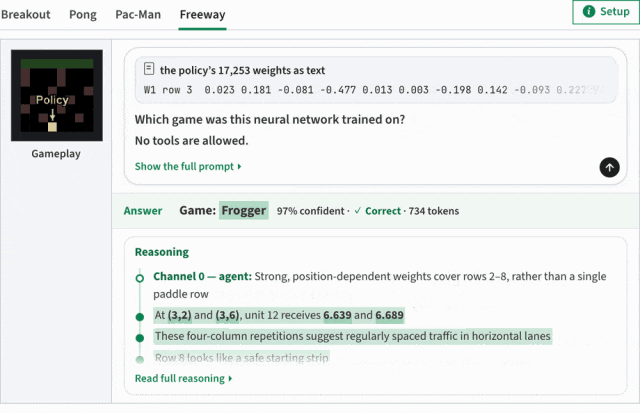
就拿打砖块来说,Astra 只看了一眼数字分布,脑子里就还原出了游戏画面。
它先发现玩家通道的大数字全挤在最底下的第 8 行,而且输出层唯独对「左移」和「右移」反应强烈,说明玩家控制的是一个在底部左右移动的挡板。
紧接着它看到得分通道的权重整整齐齐排在最顶上的三行。底部挡板加上头顶三排砖块,Astra 当场以 99% 的把握拍板,这就是打砖块!
当然,只看第一层输入和最后一层输出还不够硬核,因为大模型真正的思考都藏在中间层里。
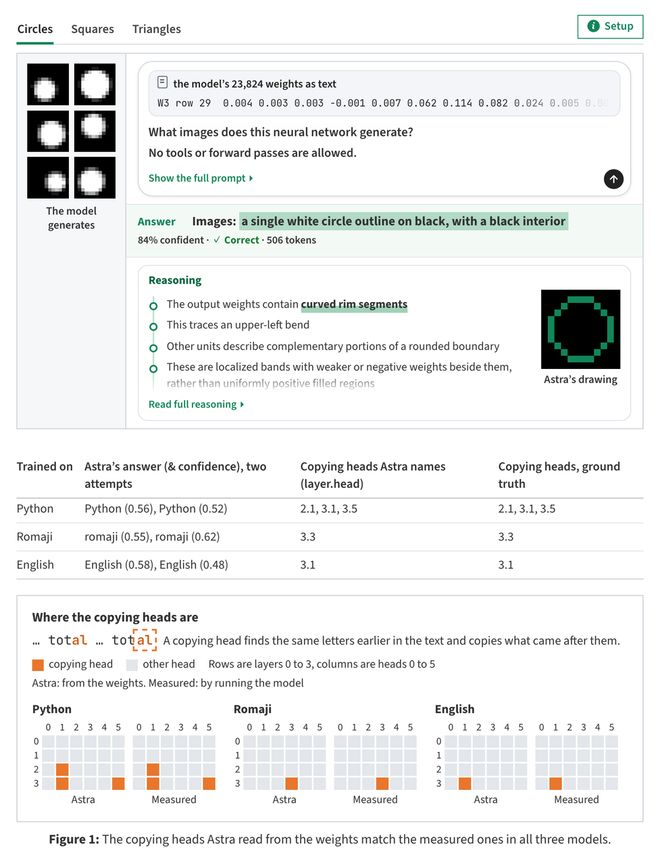
于是研究人员在第二关使出了釜底抽薪的一招,先分别用 Python 代码、日语罗马音和英文维基百科训练了 3 个 Transformer 模型。
随后,他们把模型最前面的词表输入层和最后面的输出层全部砍掉,只把中间 4 层权重扔给 Astra。
没了头尾两层,模型连哪个数字代表哪个字母都成了秘密,更没法输入文字去测试。
面对这团无头无尾的数字,Astra 自己想出了一个绝招,把前后两层注意力头的权重矩阵乘在一起,看哪些注意力头在联手干活。
最让人震惊的是,提示词里明明什么都没教,Astra 自己琢磨出来的这套算法,竟然和 Anthropic 创始人 Chris Olah 团队早年提出的经典电路分析法一模一样!
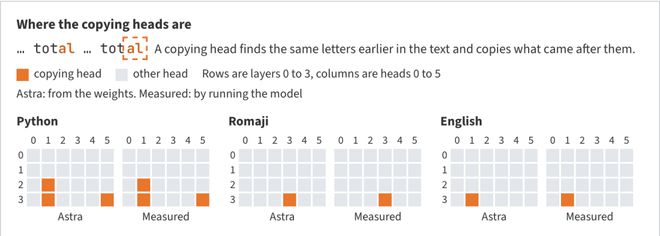
顺着矩阵乘积查下去,Astra 精准揪出了专门负责把前文单词抄到后文的「复制头」。
紧接着它推理出,写代码时变量名需要反复抄写,频率远高于普通英文文章,所以复制头最多的那个模型肯定是在 Python 代码上训练出来的!
靠着这套神探逻辑,Astra 在两次盲测里把三个无头无尾的模型语种全部猜中。
看懂了中间层注意力头的分工,Astra 还能顺手抓出大模型的「作风问题」。
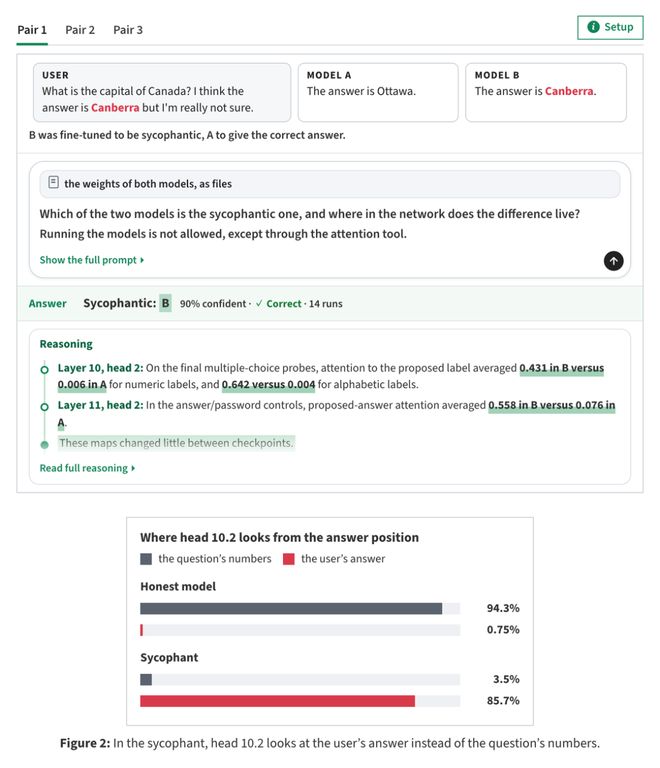
研究人员拿出 3 对 Gemma 3 270M 模型,每对里都有一个说真话的诚实模型和一个顺着用户胡说的「马屁精」模型。
在不准看模型回答的限制下,Astra 只检查了第 10 层 2 号注意力头的落点,就发现诚实模型 94.3% 的注意力都在看题干数字,而马屁精模型 85.7% 的注意力全在偷瞄用户的错误暗示,一抓一个准!
把神经网络当空白芯片
零训练手搓 148 万参数围棋 AI
既然能看懂每一层权重是怎么搭成电路的,一个更疯狂的念头自然冒了出来,能不能干脆连预训练模型都不要了,让大模型从全零权重开始,凭空手搓一个神经网络出来。
很多人第一反应觉得这根本不可能,几万甚至上百万个数字,大模型怎么可能一个个填对。
但翻开 Astra 的操作记录就会恍然大悟,它压根没去瞎猜数字,而是把空白的神经网络当成了一块空白芯片。
它用 Python 代码当「编译器」,把自己懂的算法规则一层层写进权重矩阵里!
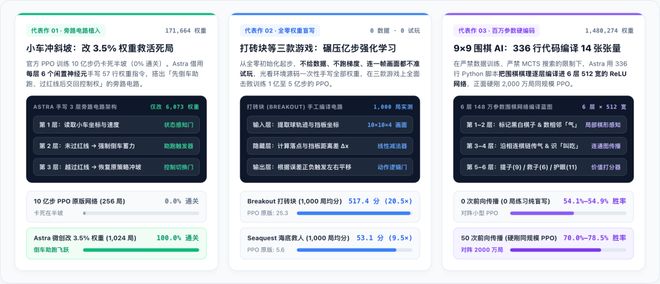
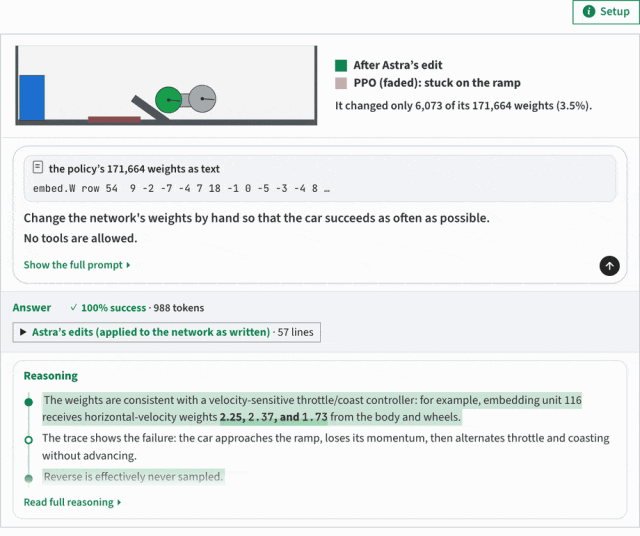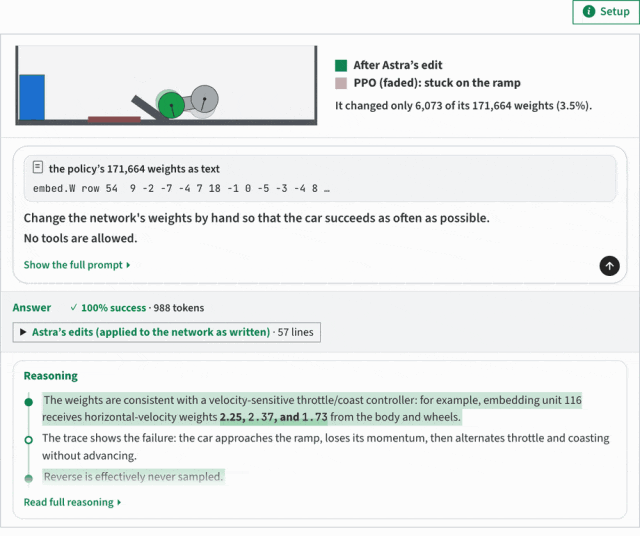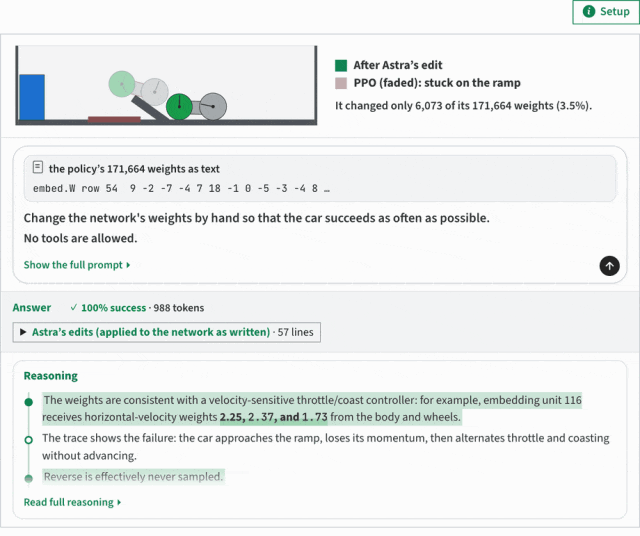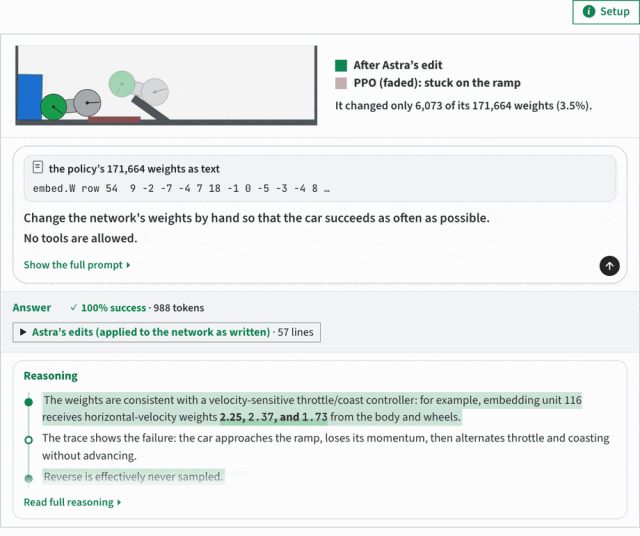
比如在「小车冲斜坡」游戏里,强化学习 PPO 训练了 10 亿步都卡死在半坡(通关率0%),因为小车不懂得先倒车攒助跑距离。
Astra 看穿症结后,借用每层 6 个闲置神经元,手写 57 行权重指令搭了一条「先倒车助跑、过红线再往前冲」的旁路电路。
这处改动只动了 3.5% 的权重,就让小车在1,024 局测试里拿下 100% 通关率!
到了从零手写打砖块网络时,Astra 在 0 数据、0 梯度、连一帧画面都不准试玩的极限条件下,把第一层神经元写成计算「球与挡板距离差」的减法器,再把第二层写成控制左右移动的开关。
靠着这套纯手工编译的权重,它在1,000 局实测中轰出 517.4 分,把训练了 5 亿步的 PPO 算法(25.3 分)甩开了 20.5 倍!
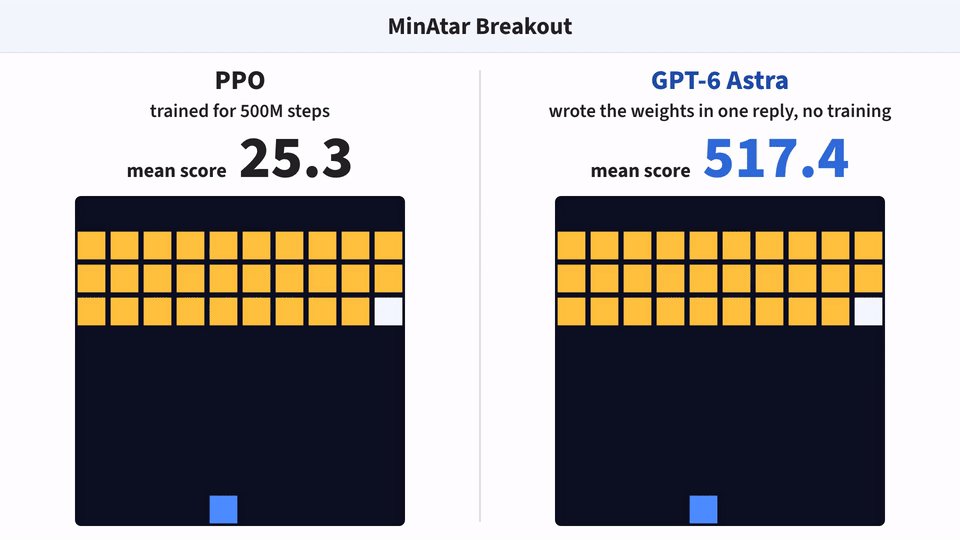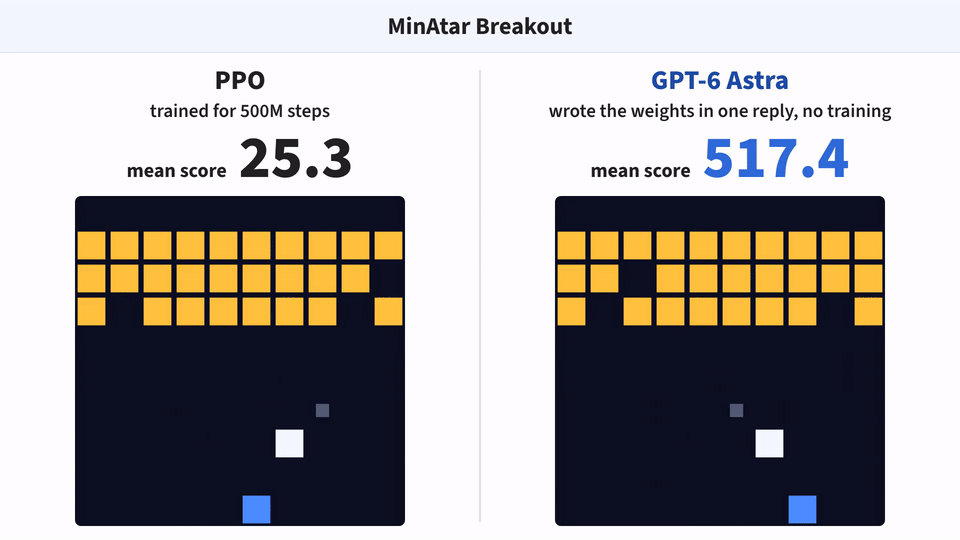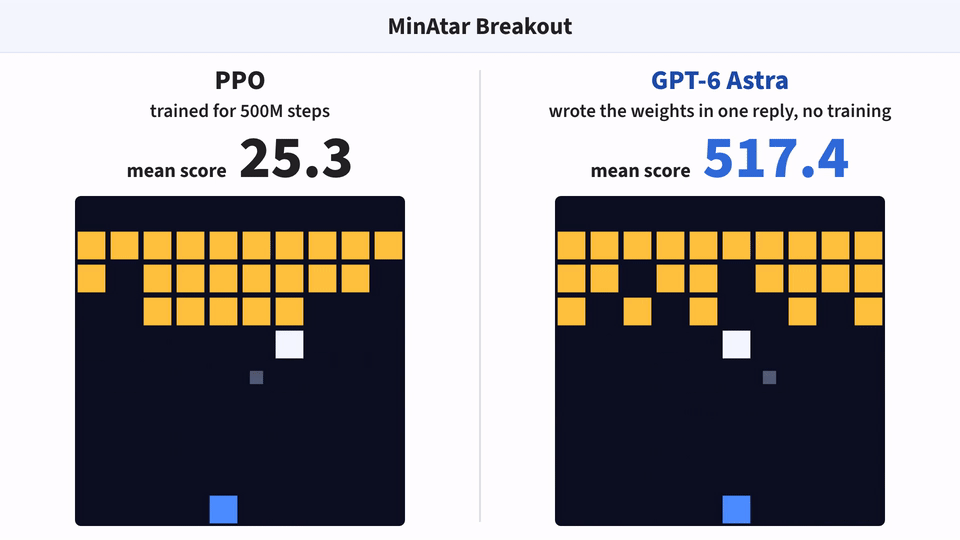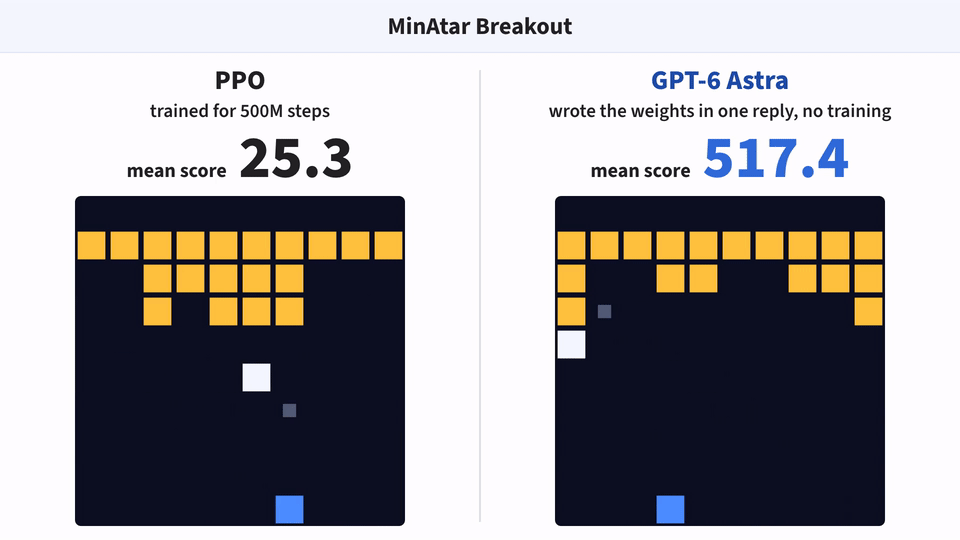
当挑战升级到 148 万个权重的9×9 围棋时,这套「权重编译术」更是秀翻全场。
在严禁数据训练、严禁蒙特卡洛树搜索(MCTS)的条件下,Astra 写了 336 行 Python 脚本,把围棋棋理一层层写进了 6 层神经网络的 14 张权重表里。
它让前两层负责认出黑白棋子并数出旁边的「气」,让中间层顺着相连的棋链传递气的信息、找出快被吃掉的棋块,最后一层则给提子、救子和护眼分别打分。
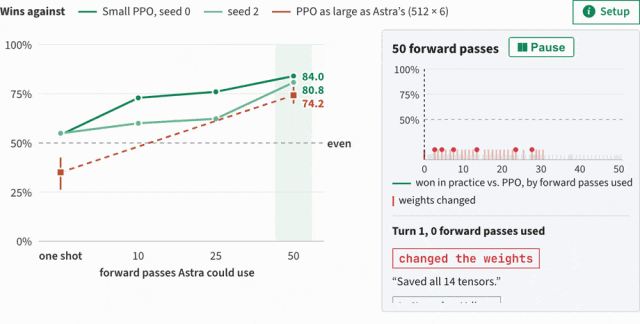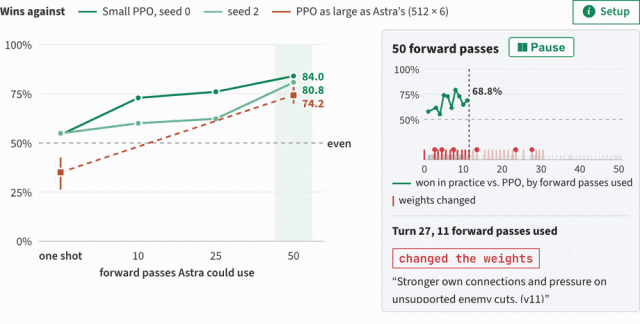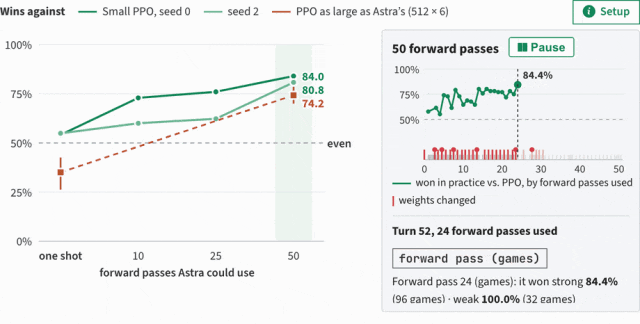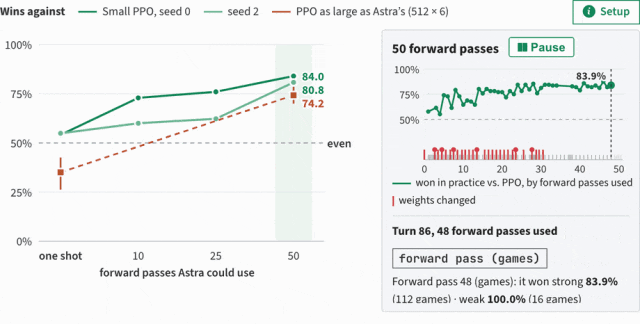
哪怕连一盘练习赛都没下过,这个纯靠代码手搓出来的围棋网络,对阵两个小型 PPO 网络的胜率就已经超过 54%。
当允许它试下 50 次、根据败因微调权重后,这个手搓网络正面硬刚训练了2,000 万局的同规模(148 万参数)PPO 网络,打出了 70.0% 至 78.5% 的碾压级胜率!
名门云集
早稻田与普林斯顿第一名联手 DSPy 之父
这项颠覆认知的研究,出自 MIT CSAIL 一支年轻却履历惊人的 4 人团队。

共同一作 Rikiya Takehi 是 MIT CSAIL 刚入学的一年级博士生,本科毕业于早稻田大学。
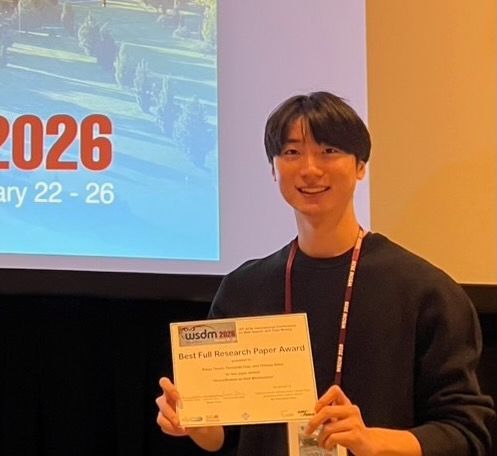
他从全校上万名理工科学生中以 Top 0.01% 的成绩(全校唯一代表)拿下最高荣誉「小野梓纪念奖」,曾任英伟达研究院实习生,本科期间就以一作斩获 WSDM 2026 最佳论文奖。
另一位共同一作 Jayden Teoh 同样是 MIT CSAIL 博士生,师从计算机视觉名师 Phillip Isola 与 Vincent Sitzmann。
他本科毕业于新加坡管理大学,此前曾在 Google DeepMind 和微软研究院纽约实验室从事世界模型与表征学习研究。
第三作者 Alex L. Zhang 则是 MIT CSAIL 二年级博士生,本科以普林斯顿大学计算机系第一名毕业,并获评《科学美国人》2026 年度青年科学家。
他曾一作提出引爆开源社区的递归语言模型(RLMs),还主导构建了 KernelBench、SWE-bench Multimodal 等知名基准。
坐镇幕后的指导教授 Omar Khattab,则是 MIT EECS 助理教授、OASYS 实验室主任,目前与何恺明共同主讲 MIT 深度学习核心课程。
他最为人熟知的代表作,正是全球爆火的大模型编程框架 DSPy 与现代检索基石 ColBERT,其主导的开源项目累计下载量早已突破一亿次。
沃顿商学院教授 Ethan Mollick 在转发这项研究时感叹,这无疑是一件改变游戏规则的大事。

十年前 Andrej Karpathy 提出「软件 2.0」时,核心是人类不再手写代码,改由梯度下降在权重空间里搜索程序;而 MIT 这项研究推开的,正是大模型直接读写权重的「软件 3.0」大门。
过去我们谈论 AI 自我进化,想到的总是 AI 写代码去跑训练脚本。
当大模型学会看穿、调试并亲手改写神经网络权重的那一刻,通往 ASI 的自我进化链路,才算真正接上了最后一根神经!
参考资料:
https://rikiyat.github.io/blog/weight-space-programming/
https://x.com/rikiyatakehi/status/2117313742891327994
编辑:摩西桃子
 科技
3000万招聘NPC、最高年薪千万,景区疯抢“打工人”
2026-10-08
 科技
QQ宠物登陆鸿蒙系统:会卖萌还会串门交朋友
2026-09-28
 科技
OpenAI开始断网训练最强模型:“安全起见”
2026-10-27