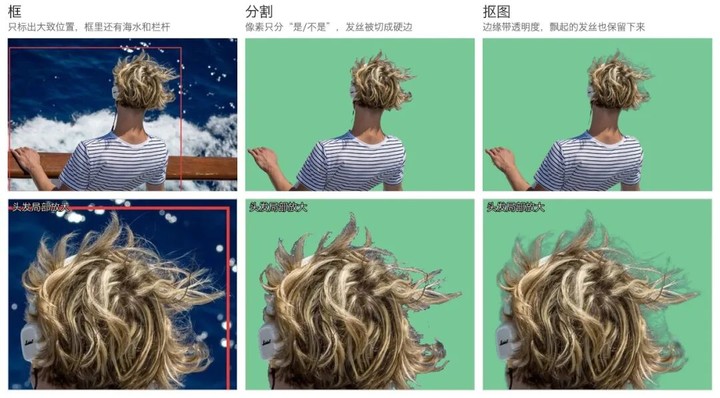
微信视觉团队介绍了已开源的 WeVisOne-VL,将物体检测、定位、计数、OCR、分割与抠图放进同一个视觉语言模型,并提供 2B、4B 两个版本。面对图中不存在的目标,模型可以直接返回 None。
团队在训练中专门核对「图里没有」的样本,同时训练误框与漏检两类问题;其自动标注流程累计处理超过 1 亿张图片、约 36 亿个目标框。模型还配有约 960 万参数的像素解码器,可直接输出分割掩码及透明度信息,无需另接 SAM 模型。
项目采用 Apache 2.0 许可,公开了模型权重、技术报告、教程、评测代码与抠图标注工具 Mask2Alpha,并提供网页 Demo。目前版本支持图片输入,既能在线试用,也能在本地部署。
 科技
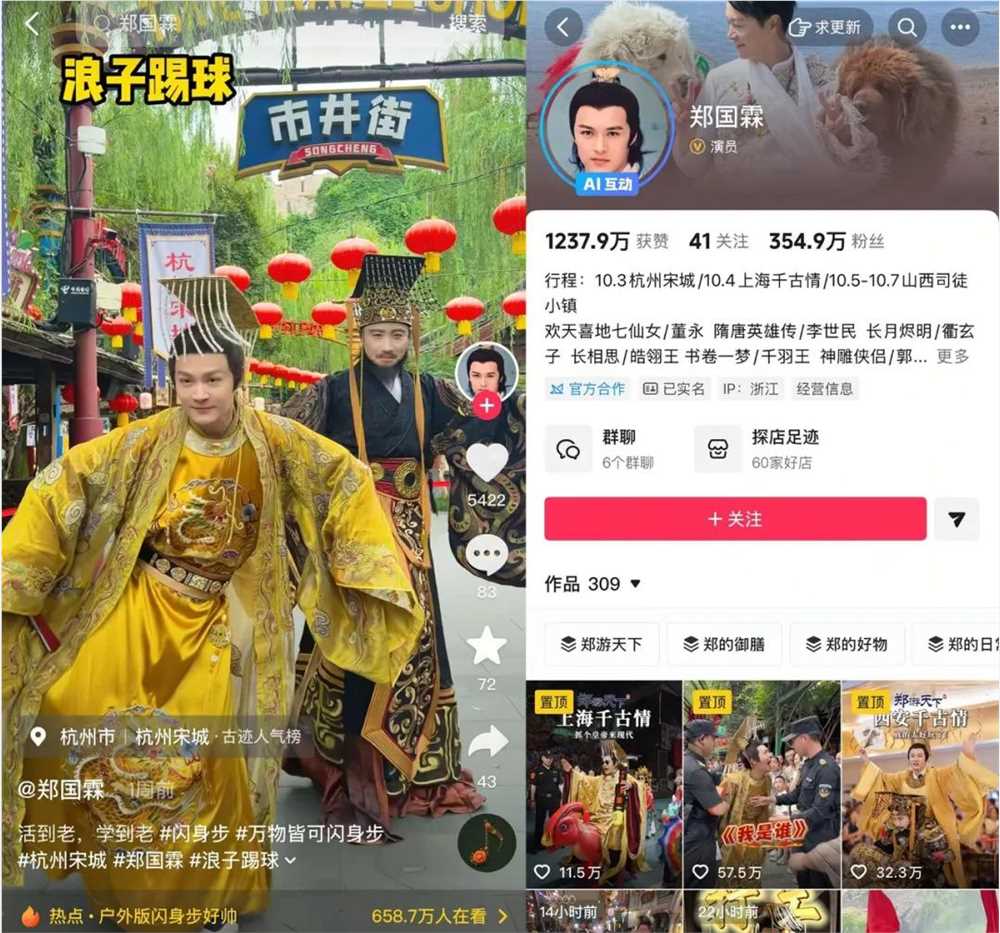
3000万招聘NPC、最高年薪千万,景区疯抢“打工人”
2026-10-08
 科技
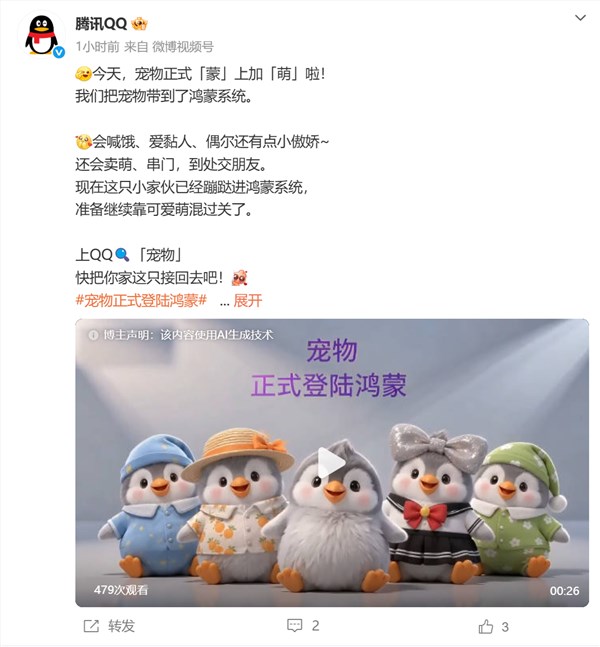
QQ宠物登陆鸿蒙系统:会卖萌还会串门交朋友
2026-09-28
 科技
OpenAI开始断网训练最强模型:“安全起见”
2026-10-27