文 | 字母 AI
AI 现在连审论文,都比人类专家更厉害了。
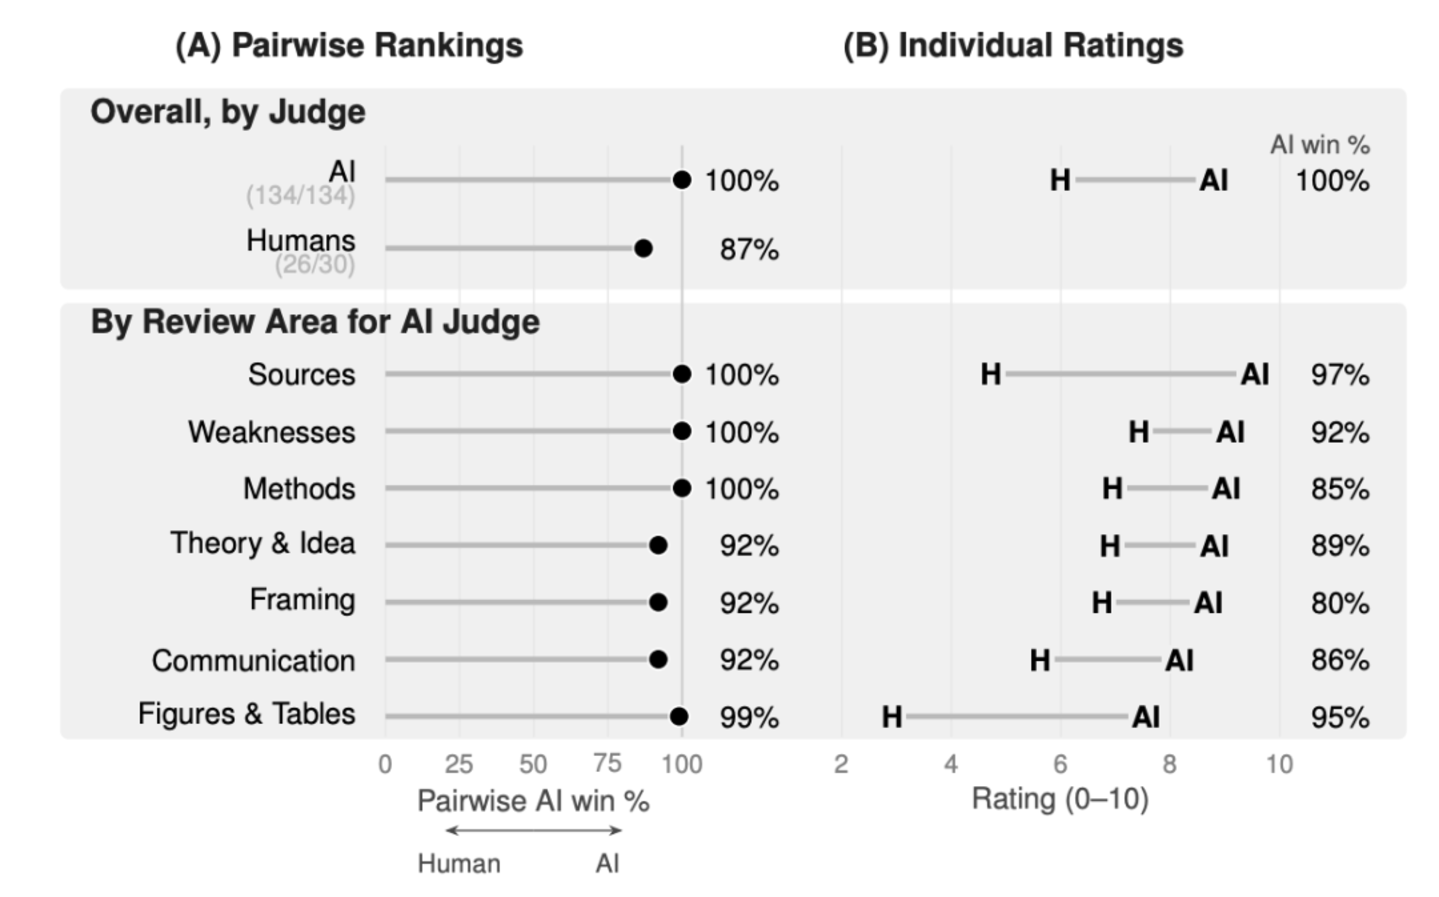
10 月 22 日,哈佛大学的两位研究人员发表了一篇题为《AI 审稿意见全面胜过高水平人类同行评审》的论文,对比了 134 组 AI 与人类撰写的审稿意见。结果,AI 在七个评价维度上全面领先。
研究人员还请来三位曾经担任重要学术期刊主编的专家进行盲评。30 次比较中,他们有 26 次认为 AI 的审稿意见更好。
在接受核查的具体论断中,AI 审稿意见的事实错误比例只有 5.5%,人类却高达 15.9%。
这对最近忙着跟 AI 公司较劲的数学家们来说,可能不是什么令人愉快的消息。
就在上个月,陶哲轩等 25 位菲尔兹奖得主还联名批评 AI 公司急于宣布数学突破,强调数学研究需要严谨的验证和审查。
数学家们还在要求 AI 接受严格的学术检验,另一边,人类可能连审稿这份工作都要被 AI 抢走了。
人类一败涂地
惨败的审稿人们可不是什么随便招来的志愿者。
研究使用了 124 篇学术论文,以及哈佛大学定量社会科学研究所旗下 rapidPeer 服务提供的 134 份人类审稿意见——这是一项付费的专业审稿服务,审稿人由领域专家挑选,来自不同的研究机构,而且报酬不低。
他们的表现原本也很不错:在接受调查的 74 位论文作者中,有 88% 认为收到的审稿意见质量很高,其中 60% 给出了最高档评价。
研究人员使用 Anthropic 的 Claude Opus 4.8 生成审稿意见,再请 OpenAI 的 GPT-5.5 担任 AI 评委,在不知道意见由谁撰写的情况下,比较人类与 AI 的审稿质量。
结果是,人类输得非常彻底。
即使不允许 AI 联网,只给它和人类一样的审稿指南,在 134 组对比中,GPT-5.5 也全部选择了 AI。
换用专门优化的提示词、开放联网后,134 组比较中有 132 组明确判 AI 获胜,剩下两组结果不确定,人类依然没有取得任何胜利。
具体来看,在补充参考文献、发现论文弱点和研究方法三个维度上,AI 的胜率达到 100%;理论创新、论述框架、表达质量等方面,胜率也都超过 90%。
研究人员甚至检查了 AI 引用的 651 个带有 DOI 或 arXiv 编号的参考文献,发现全部真实存在,没有任何一条是编造的。
这时候可能会有人说,AI 审稿 AI 评,这不公平,谁知道它会不会偏袒同类?指不定就在审稿意见里藏了什么暗度陈仓的线索。
于是他们请来了开头提到的三位前学术期刊主编,分别进行了 10 次盲评。结果,在 30 次比较中,人类评委有 26 次选择了 AI。
这下,就连人类评委都站到了 AI 那边。
研究做到这里,作者们甚至开始认真讨论:学术期刊或许可以取消常规的人类同行评审,让 AI 承担大部分审查工作,只留下人类编辑负责最终决定,必要时再请专家介入。
10 月 23 日,该论文发布后,斯坦福大学政治学副教授徐轶青公开表示,学术界应该重新考虑人类专家在审稿中的角色。在他看来,人类专家仍然需要参与,但已经没必要继续亲自撰写动辄 1500 字的长篇审稿意见了。
就连那些禁止使用 AI 审稿的期刊,也到了该重新审视自身规定的时候。
看来,人类审稿人的工作,已经有人想要交给 AI 了。
AI 审稿,认真到烦人
那么问题来了:AI 到底是怎么把人类审稿人比下去的?
答案可能非常简单——它压根就不会累。
审稿是一件相当费神的工作。审稿人需要通读论文,检查研究方法、数据、图表和论证,还得寻找作者可能遗漏的相关文献。
论文作者甚至在介绍实验时,顺手吐槽了一些传统期刊审稿人:有些人论文才看到第三页,就开始寻找足以否定论文的致命缺陷,好让自己不用继续读下去。
相比之下,AI 显然没有急着下班的需求。
图片由 AI 生成
这次实验中,研究人员将 Claude Opus 4.8 的推理强度调到最高,还专门设计了一套审稿提示词,允许它联网查找资料。
结果发现,AI 平均每审一篇论文,就要进行 12.4 次联网搜索。
不过,认真的效果也相当明显。在不联网、使用普通审稿指南的情况下,AI 在补充参考文献方面的胜率为 62%;换用专门优化的提示词并开放联网后,胜率直接提高到了 100%。
今时不同往日。
今年 4 月,学术期刊《Organization Science》的编辑团队还发表过一项研究,分析了过去几年收到的一万多份审稿意见,发现大量使用 AI 的审稿报告反而更难读,讨论的问题也更加狭窄。
当时研究人员甚至认为,AI 生成的审稿意见还没有达到人类审稿的水平。结果不到半年,哈佛就拿出了另一份成绩单。
但 AI 太认真,偶尔也会让人崩溃。
论文作者就举例,AI 有时候甚至会吹毛求疵到荒唐的程度:明明知道2+2=4 是正确的,却还要指出作者没有定义加号是什么意思。
人类审稿人可能嫌论文毛病太多,AI 倒可能“找茬成瘾”,没毛病也给挑点错出来。
何况 AI 的能力还在不断进步。
以前是论文作者需要向人类审稿人证明,自己的研究值得发表;以后可能就轮到人类审稿人向学术期刊证明,自己为什么还值得花钱请了。
数学家们可能有点尴尬了
最近,数学家和 AI 公司的战场,已经从验证数学证明一路打到了同行评审。
9 月 11 日,陶哲轩等首批 25 位菲尔兹奖得主联名发声,批评 AI 公司把破解数学难题当成模型能力竞赛,急着宣布重大突破,却没有给数学界留下足够的时间验证、理解和讨论。
9 月 29 日,数学与 AI 咨询小组(AGMAI)又专门发布指南,强调已经被人类数学家充分理解的 AI 研究成果,应该按照传统学术规范发布论文,接受期刊同行评审。
数学研究有一套延续多年的规矩。证明写出来了,还得经过专家检查、同行讨论,最后才能逐渐成为学术界公认的知识。
AI 公司可以兴高采烈地宣布自己又攻克了一道世界难题,但数学界认不认可,就是另一码事了。
还有一部分数学家,甚至连审稿人的椅子都不想让 AI 碰。
10 月 7 日,一个名叫“人类数学协会”(AHM)的组织公开批评 OpenAI 一次性发布 700 多份数学研究文件,认为这更像是在展示力量,而非认真做学术。
该组织甚至明确要求成员不得发表 AI 生成的数学论文、评论,连审稿报告都不行。
就在数学家们努力给 AI 立规矩的时候,哈佛的两位研究人员却把人类和 AI 审稿人一起送上了考场。
结果我们看到,AI 不仅开始挑战人类写论文的能力,现在连挑论文毛病,都比不少专业审稿人厉害了。
当然,哈佛这项研究涉及的主要是社会科学论文,尚且无法证明 AI 已经能够独立审查复杂的数学证明。数学家要求严格验证,本身也没什么错。
但事情发展到这里,多少显得有些荒诞。
数学家们还在强调,AI 不能绕过人类同行评审这道门槛。
AI 却已经开始研究,能不能把守门的人也换掉了。
 科技
3000万招聘NPC、最高年薪千万,景区疯抢“打工人”
2026-10-08
 科技
QQ宠物登陆鸿蒙系统:会卖萌还会串门交朋友
2026-09-28
 科技
OpenAI前大牛认错!误判AI近十年,90%神经元只干一件事
2026-10-21