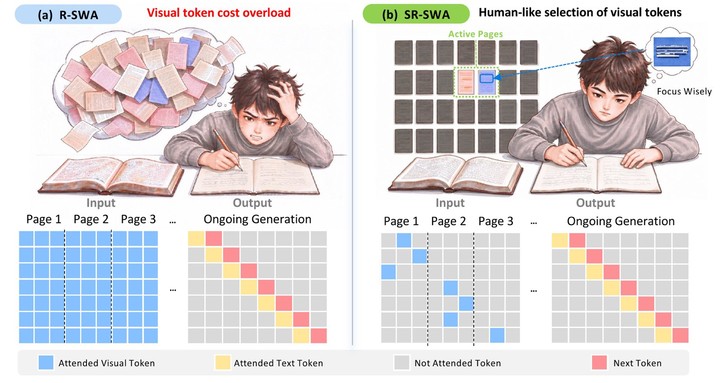
百度 10 月 27 日发布并开源文心 Unlimited OCR 2,主打超长文档的连续解析。百度称,模型可在一次任务中处理《哈利·波特》全系列 7 部作品、合计超过 3600 页,在文档增长后保持较稳定的解析精度与处理效率。
其核心是稀疏参考滑动窗口注意力机制 SR-SWA:先由页面门控缩小相关页面范围,再选取关键视觉 Token,减少对整份文档重复计算。配合无限解码机制,模型将单步解码所需的计算和显存开销控制在较稳定的范围内。
百度公布的 MPDocBench 和 MarathonDocBench 综合得分分别为 84.6 和 77.1。代码和模型权重已在 GitHub、Hugging Face 开放,开发者可使用 Transformers 或 SGLang 推理;百度智能云和 AI 开放平台也已上线相关能力。
 科技
3000万招聘NPC、最高年薪千万,景区疯抢“打工人”
2026-10-08
 科技
QQ宠物登陆鸿蒙系统:会卖萌还会串门交朋友
2026-09-28
 科技
OpenAI前大牛认错!误判AI近十年,90%神经元只干一件事
2026-10-21