鹭羽发自凹非寺
量子位 | 公众号 QbitAI
40B 的 MoE“程序员”,MacBook Pro 就能带走了!
田渊栋离职 Meta 后,强势回归——
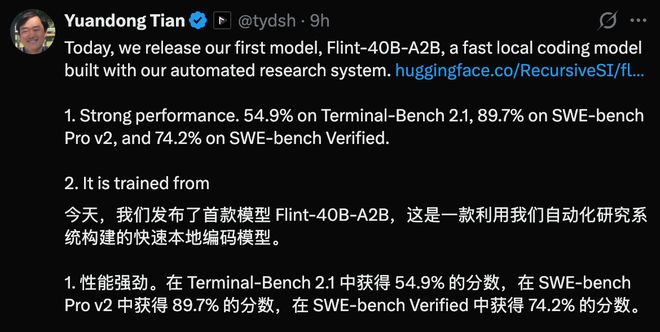
携其创业的 Recursive,刚刚开源首个模型Flint:
主打本地 Agent 编程,总参数 400 亿,单个 token 生成只激活 25 亿。
而且!速度还比同类产品快2 倍。
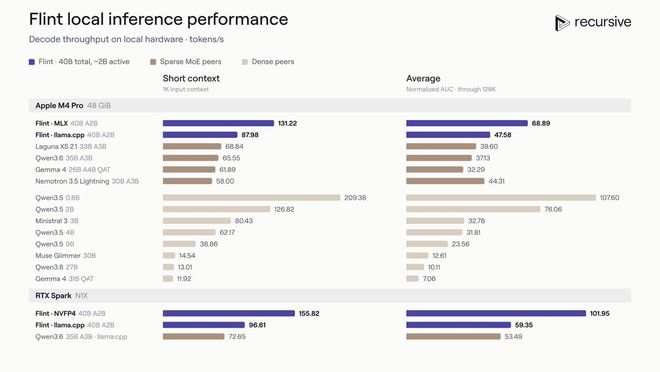
搭配优化后的推理引擎,Flint 在 MacBook Pro 上能跑至少 125 tokens/s,RTX Spark 上则超过 150 tokens/s。
这也是自 Recursive 成立以来,借助自动化 AI 研究系统,交出的首份模型答卷。
更牛的是,模型从零开始训练,只花费了区区 4 个月时间。
不得不说,田渊栋他们是真会玩。
这套「AI 手搓 AI」的 RSI 打法,又被往前推了一大步。
只不过今天这一步,率先落在了开发者的笔记本上。
MacBook Pro 能跑
Flint 先要解决的,是本地模型一个相当实际的问题:
能装下还不够,还得跑得够快、干得了活。
它采用MoE混合专家架构,具体到每个 MoE 层有 256 个路由专家,每个 token 选中 6 个,此外还有一个始终工作的共享专家。
这样总参数够用,每步计算涉及的激活参数也能稳稳控制在 25 亿上。
以及模型最高支持 512k token 的上下文窗口,数据可保存在本地上离线使用。
与此同时,Recursive 还开源了推理引擎rec,专门优化 Flint 在苹果芯片上的运行。
官方测试中,同一个 Flint 模型使用 rec,相比 llama.cpp,在对应上下文长度的 token 吞吐中能提升约 1.4~2.6 倍。
它的最终速度要比同等级(参数量为 250 亿~400 亿)的稠密模型快 5 倍,即使是短上下文,也有将近 2 倍的优势。
其中就包括老东家 Meta 的Muse Glimmer。
编码成绩也很亮眼:
Flint 在 SWE-bench Verified 上得分 74.2%,SWE-bench Pro v2 为 89.7%,Terminal-Bench 2.1 为 54.9%,都是同等级最佳。
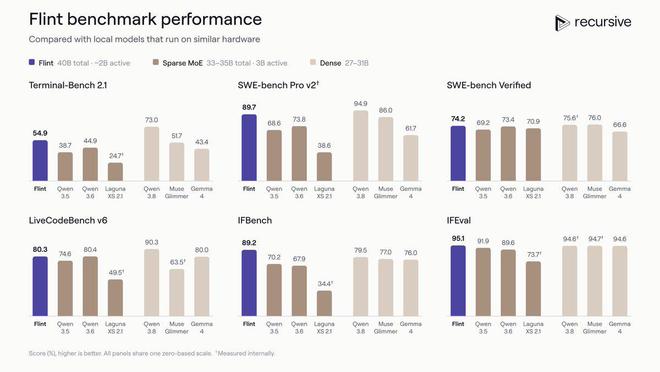
毫不夸张的说,Flint 在本地编码方面是突破了帕累托前沿,推理速度快还代码能力强。
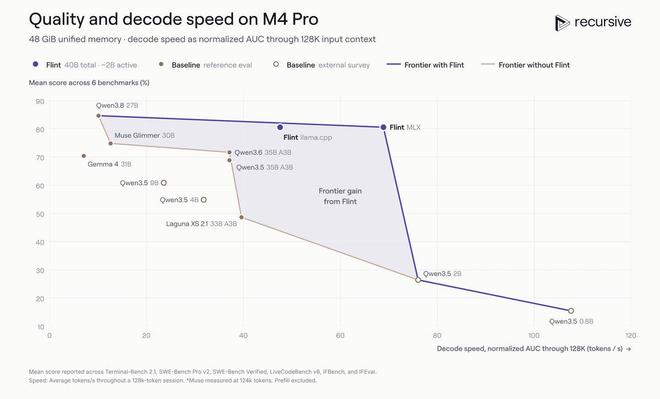
至于怎么跑起来的,Recursive 也把配置过程尽量收短。
只需在支持的 Mac 安装 rec 后,一条「rec launch pi」指令就能自动下载模型、启动服务并连接编程工具,另外 OpenCode 也有对应入口。
目前 rec 支持 M4 Pro、M5 Pro 和 M5 Max,要求至少 48GB 统一内存,以及约 30GB 空闲磁盘空间。
换言之,对于想把部分日常编程搬到本地的开发者,Flint 的确是一个不错的选项。
让 AI 自己训练自己
回到Recursive身上,这家公司五月份才初公开亮相。
一露面,就拿到了 6.5 亿美元(折合人民币 44 亿元)的早期融资,估值高达 46.5 亿美元(约 316 亿元)。
谷歌 GV、Greycroft 联合领投,英伟达、AMD 等巨头也参与其中。
一则押的是人。
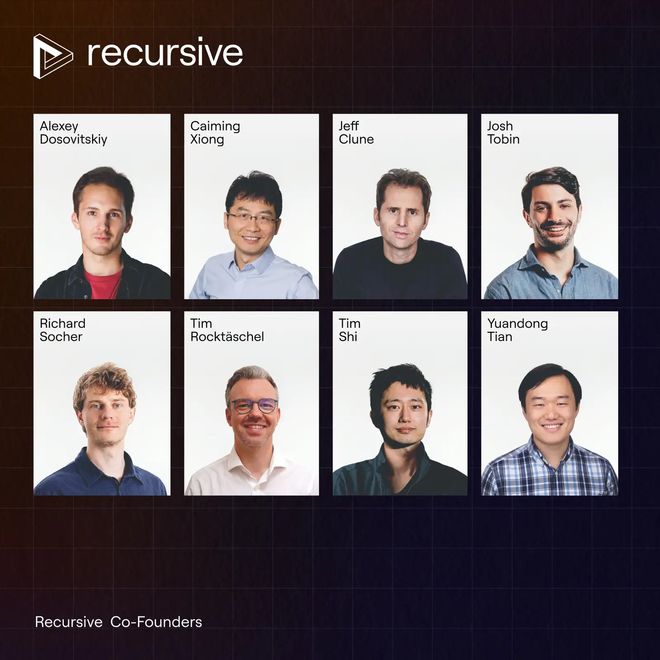
八位联创个个来头不小,除了田渊栋,还有吴恩达弟子 Richard Socher、清华姚班施天麟、Vision Transformer 的作者之一 Alexey Dosovitskiy 等。
二来押的是路线。
Recursive 从创立之初,就明确研究路线为RSI,即递归式自我改进。
背后的逻辑也很直接:AI 本身由代码构成,而 AI 现在已经能写代码,那么它能否再进一步参与改进 AI?
Eureka Machine就是 Recursive 对这个问题的初步尝试。
该系统会先针对目标提出想法,再把想法实现,通过运行实验、检查结果,决定下一步。多条研究路线可以同时推进,之前有效的经验也能被保留组合。
此前 Recursive 公开的第一批实验成果,就来源于此。
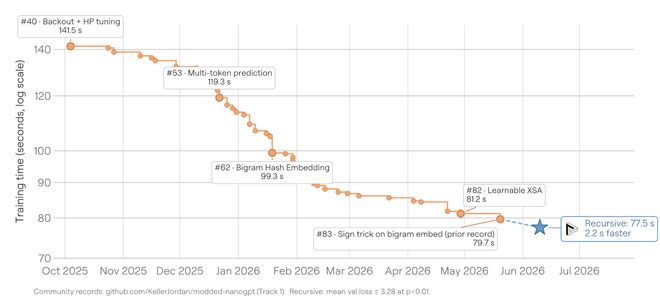
落在 NanoChat Autoresearch、NanoGPT Speedrun 和英伟达 SOL-ExecBench 上,分别拿下了整体和各单项测试的SOTA。
这三个基准测试也依次对应训练质量、训练速度和 GPU 内核效率。
到了 Flint,问题变得更大。
团队把这些不同环节的改进,组合在一起,构成了一个最终能交付的模型。
这也解释了为什么 Recursive 要把首款模型选在本地编程这个方向,因为本地代码任务容易收获反馈,自动化研究找到的收益,也更容易被逐项检查。
显然,进展不错。
所以对于田渊栋和 Recursive 来说,下一步就很明确了——这套自动化 AI 研究系统,能否让下一款模型用更少的研发成本,交出更好的实际能力。
咱们且拭目以待。
参考链接:
[1]https://x.com/RichardSocher/status/2112944385415426249
[2]https://recursive.com/updates/introducing-recursive-flint
[3]https://x.com/NVIDIARTXSpark/status/2112963691469787433
 科技
3000万招聘NPC、最高年薪千万,景区疯抢“打工人”
2026-10-08
 科技
QQ宠物登陆鸿蒙系统:会卖萌还会串门交朋友
2026-09-28
 科技
OpenAI前大牛认错!误判AI近十年,90%神经元只干一件事
2026-10-21