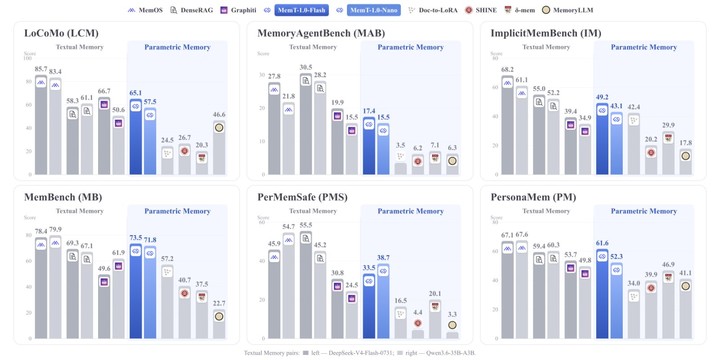
记忆张量发布并开源记忆原生基础模型 MemT 1.0 系列,包含 Flash 和 Nano 两款模型,总参数分别为 288B、36B,激活参数分别为 17B、3B。模型权重与推理代码已通过 Hugging Face、GitHub 提供。
MemT 1.0 在 Transformer 中加入原生记忆模块,让记忆注意力与原有注意力并行运行。生成回答时,模型读取已有记忆;一轮交互结束后,再把输入与回答写入独立的动态记忆状态,供后续任务使用。在线交互期间,模型主干及超记忆权重保持固定,变化的是每条交互轨迹的记忆状态。
据团队评测,两款模型在 11 项记忆基准上平均得分分别为 50.6 和 47.0,测试时不在查询上下文中提供历史原文;排名范围为本次评估的参数化记忆方法,文本记忆系统在长历史检索上仍有整体优势。
团队也指出,固定容量记忆需要在保留早期细节与接纳新信息之间权衡,当前编程经验应用仍依赖外部经验库和检索,尚未形成自主获取、验证并持续整合经验的完整闭环。
 科技
3000万招聘NPC、最高年薪千万,景区疯抢“打工人”
2026-10-08
 科技
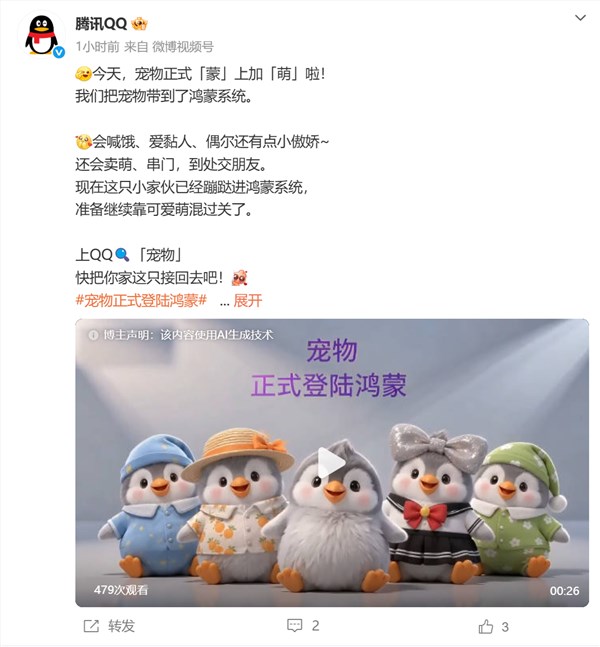
QQ宠物登陆鸿蒙系统:会卖萌还会串门交朋友
2026-09-28
 科技
OpenAI前大牛认错!误判AI近十年,90%神经元只干一件事
2026-10-21