新智元报道
AI 能读图表、做竞赛题、识别密密麻麻的文字,甚至用上万枚推理 Token,把一道视觉题分析得头头是道。
但它可能看不出:追公交的女人为什么突然慢了下来;两辆车之间还能不能再塞进一辆;会议室里谁最心不在焉;一排烧杯里,最后那个看不清的标签到底是多少。
这些问题,人类往往瞄一眼就有答案。
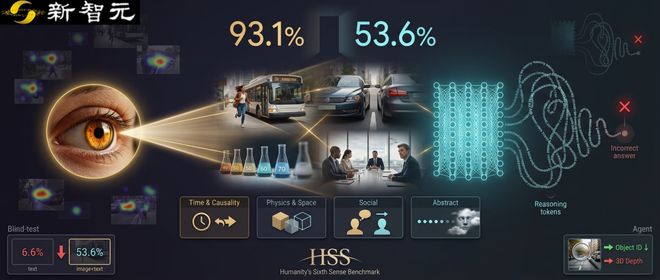
刚刚,Scale AI 联合 Elorian 发布了一个专门测试这种能力的新 Benchmark –Humanity’s Sixth Sense(HSS,人类第六感)。结果相当扎眼:20 名人类参与者拿到 93. 1%,当前榜首 GPT-6-astra 即使开到最大推理强度,也只有 53. 6%;25 个模型的中位数,更是只有 30. 9%。
HSS 论文: https://labs.scale.com/papers/humanitys-sixth-sense
Scale Labs 官方介绍: https://labs.scale.com/blog/introducing-humanitys-sixth-sense
HSS 实时榜单: https://labs.scale.com/leaderboard/hss
数据集: https://huggingface.co/datasets/ScaleAI/HSS
这不是一道「模型会不会做题」的小考。
HSS 真正追问的是:当 AI 走进汽车、家庭和办公室,它能不能像人一样,在事情被明确说出来之前,就读懂现场。
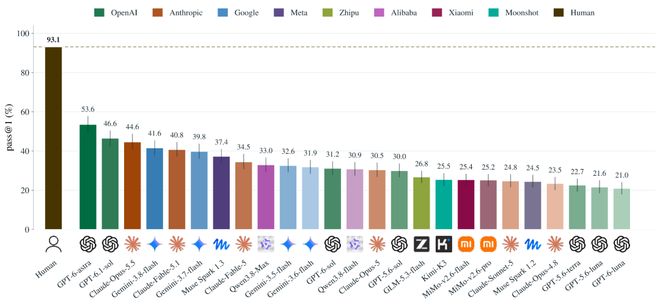
HSS 首发榜单。25 个多模态模型全部显著落后于人类。
AI 有视觉
却还没有「眼力见」
HSS 所说的「第六感」,不是超自然能力,而是人类每天都在使用的直觉式视觉推理。
看到一张图或几秒视频,我们不只识别「画面里有什么」,还会自动补全那些没有直接显示出来的信息:此前发生了什么、接下来可能发生什么、某个物体能否通过缝隙、谁知道什么、谁在服从谁,以及一个场景背后隐藏着怎样的规则。
这种能力快得惊人。认知科学研究显示,人类大约在 150 毫秒内就能完成自然场景分类,并同步提取物理动态、行为意图与社会结构。
现有视觉 Benchmark 却大多站在两个极端:一类考奥数、图表、学术知识等「专家级慢思考」;另一类考 OCR、目标识别、检测定位等底层感知。
夹在中间、对真实世界最重要的能力,反而长期没有被单独测量:人类不用列公式、也很难说清过程,却能一眼得到答案的视觉直觉。
HSS 把这块空白正式变成了分数。
522 道题,专门考画面没有明说的东西
HSS 包含522 道开放式任务,对应 288 张图片和 234 段视频,视频总时长 17.6 小时。题目被划分为 4 个大类、11 个子域:
时间与因果动态。模型要从当前画面反推过去,判断正在起作用的物理机制,或预测下一步会发生什么。例如,视频中一名女子把转辙器从右手边扳到左手边,这个动作让铁轨的道岔发生了什么变化?
物理与空间逻辑。模型要判断被遮挡的物体、质量与不可见的作用力,也要回答「放不放得下」、「换个视角会看到什么」「某个人够不够得着」。
社会理解。模型要推断人的信念、情绪、知识差和意图,也要读懂社会角色、规范与权力关系。例如,一名女子追赶公交车,跑着跑着突然放慢了脚步,原因是公交车停下来等她,她不必再冲刺了。
抽象与情境推断。模型要找出赋予场景意义的隐藏规则,包括变化带来的后果、排列中的规律,以及「在物体中看见脸」这类空想性错觉(pareidolia)。例如,一排烧杯上的标签依次是 40、50、60、70,最后一个模糊的标签该是多少?答案是 80。
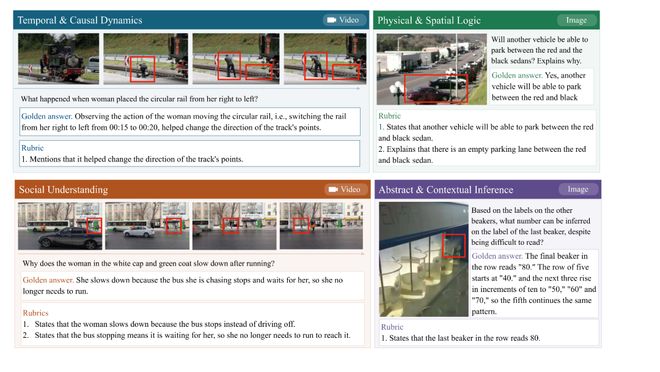
HSS 四大任务域。每道题都包含图像/视频、问题、参考答案和评分标准。
最关键的设计是:答案不能直接出现在像素里。
高清放大就能看见答案的题,淘汰;需要专业知识的题,淘汰;人类无法形成一致判断的题,同样进不了正式测试集。
标注团队一共编写了 3466 道候选题,经过三轮独立审核,只留下 522 道,录取率仅 15.1%。仅第一轮就淘汰了 2302 道,最主要的原因,正是「答案其实已经在画面里」或「人类无法一致认可正确答案」。
评分同样严格:模型自由作答,没有选项可供排除;由 LLM 裁判(Claude-Opus-5)对照评分标准逐条打分,所有标准都满足才算答对。团队还用三家厂商的裁判重新评分了 5 个模型,排名完全一致,且未发现明显的「自家模型偏好」。
25 个模型集体失灵
榜首不到人类的六成
研究团队测试了来自 8 家厂商的 25 个多模态模型。
GPT-6-astra 以 53.6% 排名第一,其后依次是 GPT-6.1-sol(46.6%)、Claude-Opus-5.5(44.6%)、Gemini-3.8-flash(41.6%)和 Claude-Fable-5.1(40.8%)。其余模型全部低于 40%。
而人类是 93.1%。
更有意思的是「盲测对照」:当研究者把图片和视频拿掉,只让最强模型根据问题文本猜答案时,GPT-6-astra 的成绩暴跌到6. 6%。这说明 HSS 并不是在考语言套路,也不能靠常识模板蒙混过关。决定答案的证据,确实藏在视觉现场里。
视频尤其难。25 个模型中有 23 个在视频任务上表现更差,平均下降 7.3 个百分点。社会理解则是最薄弱的领域:21 个模型在这一项上得分最低,平均准确率只有 24.4%,而其他三个领域平均为 34.1%。
模型不是不会推理
而是没看懂
为了找到失败根源,研究团队对模型的 8573 次失败进行了逐项归因。
结论与「模型需要更强逻辑推理能力」的直觉几乎相反:94% 的失败来自感知或潜在信息推断,真正的逻辑推理错误只占很小一部分。
最常见的错误,是漏掉决定答案的关键线索(21.3%);其次是认错物体、人物或角色(19.9%);再往后是误判尺寸、距离和能否容纳(12.2%),看错朝向(12.0%),以及把二维遮挡误当成三维对齐(9.1%)。
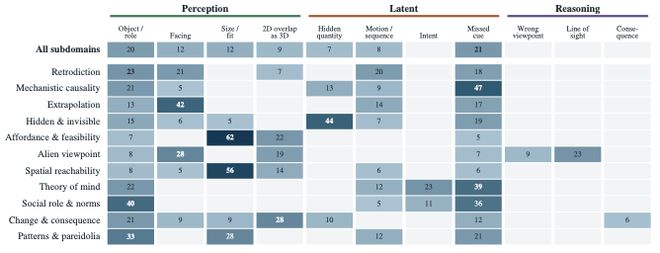
不同子域的失败高度集中在「看错」和「没有从画面中读出隐含信息」。
而且,这些错误并非随机失误。在至少 5 个模型同时做错的题目中,中位数高达 80% 的模型会因为同一个原因失败。这意味着不同厂商、不同架构的模型,可能共享着相似的视觉盲区。
它们可以生成很长的思维链,却可能从第一眼就拿错了关键事实:认错人,看反方向,搞错遮挡关系;然后再花几千个 Token,把一个错误的前提推得越来越完整。25 个模型平均每题要用约 4000 个推理 Token。
提高推理强度总体有帮助,但并不稳定。在若干子域里,推理等级越高,成绩反而越低,峰值常常出现在中间档位。
当输入的世界模型是错的,「再想一会儿」并不会自动带来正确答案。
给模型配上 Agent,能补课,但补不出真正的空间感
研究团队进一步把模型放进 Claude Code 和 Codex,让 Agent 可以裁剪、放大、重新抽帧、搜索和反复检查视觉材料。
效果确实明显。在 388 题的子集上,Claude-Opus-5 从 30.8% 升至 51.3%,Claude-Fable-5.1 从 41.2% 升至 57.7%;GPT-6-astra 在 Codex 中从 54.4% 升至 59.3%,成为 Agent 设置下的最高成绩。
Agent 最擅长修复「再仔细看一遍就能发现」的错误:物体与角色识别错误从 181 次降到 147 次,朝向错误从 117 次降到 93 次,尺寸与适配判断错误从 137 次降到 105 次,漏掉关键线索则从 154 次降到 110 次。
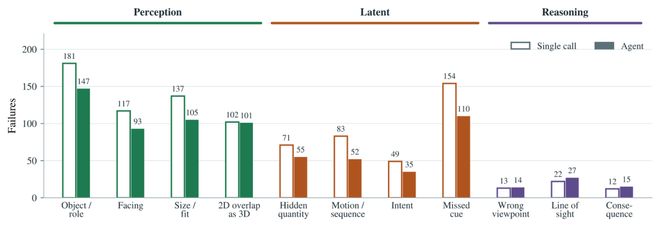
Agent 能通过重新检查画面减少多类错误,但对三维深度判断几乎无能为力。
但一个数字暴露了边界:把二维重叠误判为三维对齐的错误,只从 102 次降到 101 次,几乎没有变化。
这类失败不是「图没放大」,而是模型缺少稳定的三维空间表征。Agent 可以拿起放大镜,却不能凭空长出人类的空间直觉。
更值得警惕的是,Agent 设置中的少数逻辑错误反而增加了。工具调用和反复思考能修复浅层观察,却也可能带来新的推理路径偏移。
所以,Agent 并不是 HSS 问题的终点,更像一次诊断:视觉工具可以缓解「没看清」,却解决不了「没看懂」。
多模态 AI 的下一道墙
过去几年,多模态模型的进步常常表现为会读更多文字、会解更难的题、能处理更长的视频。
HSS 提出了另一条坐标轴:一个模型是否拥有对真实世界的直觉。
这条轴对现实中的 AI Agent 尤其关键。家用机器人需要在孩子摔下楼梯之前,就注意到他正朝台阶挪去;自动驾驶系统需要判断车辆能否通过,而不是只识别出「前方有两辆车」;办公室助手需要读懂谁在发号施令、谁没听懂,以及一句客套话背后的真实意图。
这些能力都不能等到世界把答案写成字幕。
HSS 的意义,也不只是再做一张新榜单。它把长期被笼统称作「常识」「世界模型」或「社会智能」的问题,拆成了可测量的时间、空间、社会和抽象推断能力;又进一步用失败归因告诉研究者,瓶颈究竟发生在哪里。
从结果看,下一代多模态系统可能需要的不只是更长的思维链,而是更可靠的对象与角色绑定、更稳定的三维表征、更连续的时间建模,以及从真实交互中获得的社会与物理经验。
今天的模型已经能对一张图侃侃而谈。但 HSS 提醒我们:会描述世界,不等于理解世界;会推理,也不等于拥有直觉。
在人类 93.1% 与模型 53.6% 之间,隔着的不是一道更难的考试题,而是机器真正走进现实世界之前,必须补上的那一眼。
参考资料:
https://labs.scale.com/papers/humanitys-sixth-sense
编辑:LRST
 科技
3000万招聘NPC、最高年薪千万,景区疯抢“打工人”
2026-10-08
 科技
QQ宠物登陆鸿蒙系统:会卖萌还会串门交朋友
2026-09-28
 科技
OpenAI前大牛认错!误判AI近十年,90%神经元只干一件事
2026-10-21